초고대역폭 메모리 HBM3E (ZAZ 커패시터)
High Bandwidth Memory (HBM3E / ZAZ)
초고종횡비 박막 커패시터와 TSV 관통 전극을 결합한 고성능 메모리
4.2 초고종횡비 ZAZ 커패시터 공정 및 HBM 첨단 패키징 — 1나노 컵의 기적과 3차원 AI 메모리 고속도로
🎨 눈으로 보는 구조 — 실린더 마천루와 HBM 타워
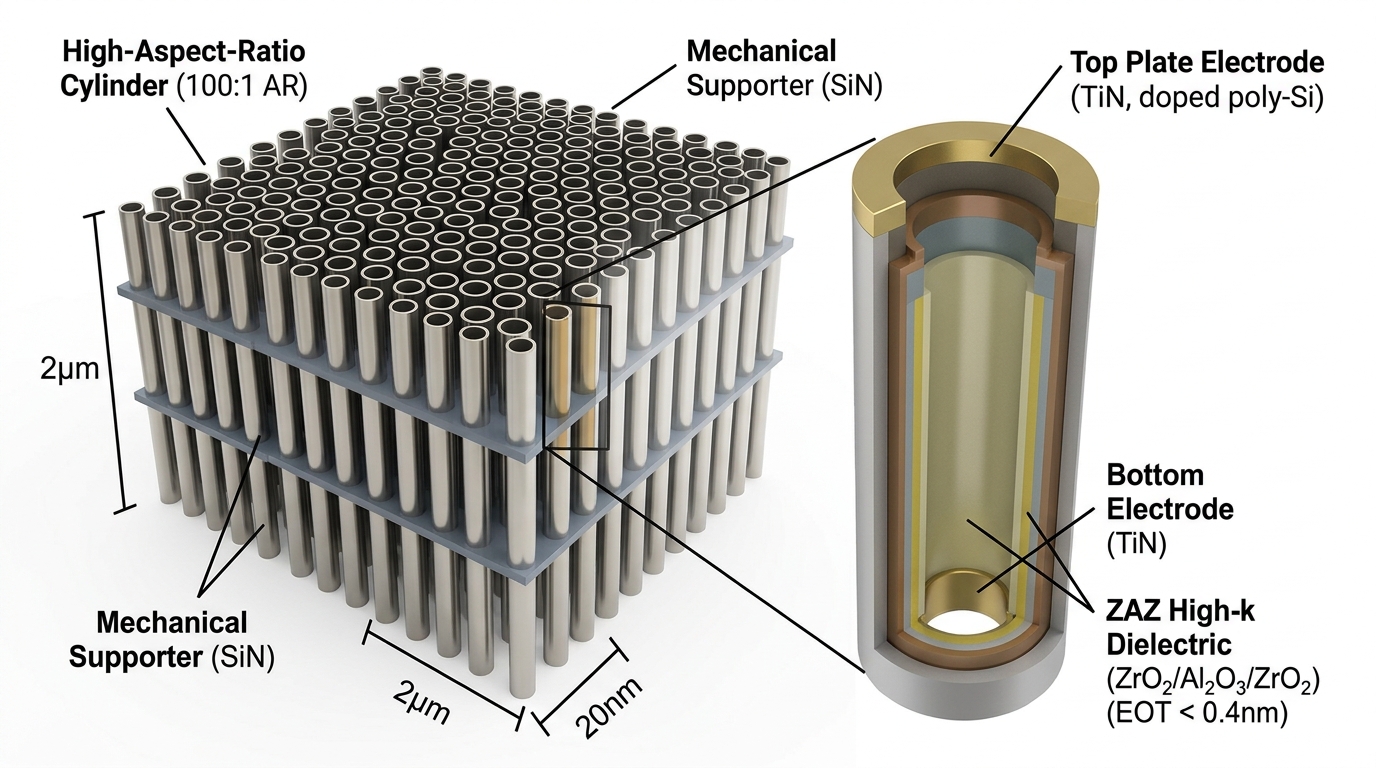
💡 [3D 공학 정밀 구조도] DRAM 초고종횡비(100:1 AR) 하니컴 실린더 커패시터 어레이 및 ZAZ(ZrO2/Al2O3/ZrO2) 원자층 유전막 적층 구조
1. DRAM 초고종횡비(HARC) 실린더 커패시터 수직 단면도
flowchart TD
    subgraph PillarCap ["DRAM 3D 초고종횡비 필라(Pillar) 커패시터 스택"]
        TOP["상부 플레이트 공통 전극 (ALD TiN / Doped Poly-Si)"]
        ZAZ["ZAZ 3중 나노 유전막 (ZrO2 1.5nm + Al2O3 0.2nm + ZrO2 1.5nm, T_phys ≈ 3.2nm, k_eff ≈ 36, EOT ≈ 0.35nm)"]
        BOT["하부 스토리지 노드 전극 (ALD TiN 필라 실린더, 깊이 2 μm, 직경 20 nm, 100:1 AR)"]
        SNC["스토리지 노드 콘택 플러그 (SNC: W / Poly-Si)"]
        TOP --- ZAZ --- BOT --- SNC
    end
    subgraph CellTransistor ["하부 4F² 셀 트랜지스터 어레이"]
        BCAT["매립 게이트 워드라인 (BCAT) + 매립 비트라인 (BBL)"]
        SNC --- BCAT
    end
2. HBM3e / HBM4 3D 적층 스택 구조도
flowchart TD
    subgraph Accelerator ["최고 성능 AI 가속기 및 인터포저"]
        GPU["GPU / AI 가속기 ASIC 다이 (NVIDIA H100 / B200)"]
        INT["2.5D 실리콘 인터포저 (Si Interposer / CoWoS: 65nm 초미세 금속 재배선로)"]
        GPU <-->|마이크로범프 초고속 인터페이스| INT
    end
    subgraph HBMStack ["HBM3E 12-Hi 적층 큐브 시스템"]
        D12["DRAM 다이 #12 (최상단 다이: TSV 없음, 기계적 휨 방지 두께 보강)"]
        TSV["수천 개 관통 실리콘 비아 (TSV) + 마이크로범프 + MR-MUF 몰딩"]
        D1["DRAM 다이 #1 (두께 30~40 μm 초박막 다이)"]
        BASE["BASE DIE (베이스 다이: 첨단 로직 파운드리 제조 PHY + BIST)"]
        D12 --- TSV --- D1 --- BASE
    end
    INT <-->|초고밀도 1024-bit 광대역 병렬 데이터 버스| BASE
flowchart TD
subgraph Cell_Fab["1. 메모리 프론트엔드: ZAZ 커패시터 공정"]
A1["몰드 산화막 + 다층 SiN 서포터 적층"] --> A2["초고종횡비(100:1, 깊이 2 μm × 직경 20 nm) 플라즈마 홀 식각"]
A2 --> A3["하부 전극(BE) ALD TiN 원자층 피복"]
A3 --> A4["ZAZ 유전체 ALD: ZrO2(고유전) + Al2O3(누설차단) + ZrO2"]
A4 --> A5["500°C 결정화 어닐(DPA) + 상부 전극(TE) TiN 매립"]
end
subgraph Middle_Fab["2. 미들엔드: TSV 관통 전극 형성"]
B1["실리콘 관통 비아 식각 (Bosch HARC)"] --> B2["SiO2 절연 라이너 + Ta/TaN 배리어 증착"]
B2 --> B3["Cu 전기도금(ECD) 보이드 무결점 충전"]
B3 --> B4["웨이퍼 이면 그라인딩 (CMP TSV Reveal)"]
end
subgraph Packaging["3. 백엔드 패키징: 12/16단 적층 접합"]
C1["베이스 로직 다이 위에 12~16개 DRAM 다이 정밀 정렬"]
C1 --> C2{"다이 접합 공정 선택"}
C2 -->|SK하이닉스| C3["MR-MUF: 일괄 리플로우 + 고열전도 액상 에폭시 몰딩"]
C2 -->|삼성/마이크론| C4["TC-NCF: 비전도성 필름 층별 열압착"]
C2 -->|차세대 HBM4| C5["Cu-Cu 하이브리드 본딩 (범프리스 직결)"]
end
Cell_Fab --> Middle_Fab --> Packaging🔍 왜 필요한가? — 메모리 셀과 대역폭의 2대 물리적 장벽
1. DRAM 셀 축소의 벽: 20 fF 센싱 마진의 법칙
DRAM은 1개의 트랜지스터(1T)와 1개의 커패시터(1C)로 1비트를 저장합니다.
비트라인(Bitline)에 연결된 센스 앰프(Sense Amplifier)가 '0'과 '1'을 오류 없이 판별하려면 커패시터에 최소 20~ 25 fF의 정전용량(C_cell)이 무조건 확보되어야 합니다:
10나노급 이하로 셀 면적이 극소화되면서 평면 면적만으로는 C_cell이 1 fF도 나오지 않습니다. 높이를 2 μm로 뽑아 올리는 초고종횡비(HARC) 실린더 구조와 유전상수 kappa > 35의 ZAZ 유전체가 필수불가결합니다.
2. 폰 노이만 메모리 벽(Memory Wall)과 HBM
아무리 뛰어난 GPU(NVIDIA H100, B200)라도 메모리에서 연산 데이터를 제때 공급받지 못하면 연산 코어의 80%가 놀게 됩니다(GPU Starvation).
기존 GDDR6/DDR5는 기판 배선 한계로 데이터 핀 수가 32~64개에 불과해 대역폭이 수십~수백 GB/s에 갇혀 있었습니다.
HBM 혁명: 1,024개(HBM3e) ~ 2,048개(HBM4)의 방대한 TSV 통로를 통해 버스 폭을 수십 배로 넓히고 거리를 마이크로미터 단위로 좁혀 초당 1.2~ 2.5 TB/s의 극초고속 대역폭을 실현했습니다.
📐 이론을 지탱하는 3대 수식과 직관적 물리
DRAM 커패시터와 HBM 대역폭은 극한의 3D 유전체 스택과 초병렬 버스 인터페이스의 결합이다.
[수식 1] 고유전율 ZAZ 스택 원통형 커패시터 정전용량 (Cylinder Capacitance)
높이 H, 반경 r의 초고종횡비 3D 실린더 커패시터에 축적되는 전하 용량:
ZrO₂(k ~ 45, 1.5 nm) / 초박막 Al₂O₃(k ~ 9, 0.2 nm) / ZrO₂(k ~ 45, 1.5 nm) 나노 스택(총 물리 두께 T_phys ≈ 3.2 nm, 실효 유전율 k_eff ≈ 36)을 적용하여 양자 누설을 차단하면서 실효 산화막 두께 EOT ≈ 0.35 nm (< 0.4 nm) 및 C_cell ≥ 20~25 fF/cell 확보
직관적 비유 (초고층 원통형 물탱크):
좁은 원룸 바닥(10nm 다이 면적)에 물탱크를 놓을 수 없어, 옥상까지 100m 높이로 솟은 3차원 초고층 원통 기둥을 세우고 안팎에 특수 방수 페인트(ZAZ 유전체)를 발라 물(전하)을 꽉 채워두는 설계입니다.
[수식 2] HBM 총 데이터 대역폭 방정식 (Total Memory Bandwidth)
초병렬 TSV 인터페이스 기반 HBM의 초당 데이터 전송 속도:
HBM3E: 9.6 Gbps × 1024 bits div 8 = 1,228.8 GB/s ≈ 1.23 TB/s
HBM4: 버스 폭을 2048비트로 2배 확장하여 단일 스택당 2.0~ 3.0 TB/s의 경이적인 대역폭 달성
직관적 비유 (초고속 1차선 아우토반 vs 2,048차선 화물 하이패스):
일반 PC 메모리(DDR5)가 64차선 도로에서 슈퍼카가 달리는 구조라면, HBM은 2,048개의 도로를 한꺼번에 열어 트럭 수천 대가 동시에 짐(데이터)을 쏟아붓는 초대형 물류 항만입니다.
[수식 3] DRAM 리프레시 데이터 보존 한계 시간 (Retention Time)
전하가 누설되어 데이터가 지워지기 전 다시 읽고 써주어야 하는 리프레시 주기:
셀 트랜지스터 접합 누설과 유전체 터널링으로 인해 통상 64 ms 주기마다 메모리 전체를 충전해야 하며, 온도가 85^°C를 넘으면 누설이 2배로 뛰어 리프레시 오버헤드가 급증
직관적 비유 (바닥에 구멍 뚫린 양동이 채우기):
물탱크 바닥의 미세한 구멍(누설 전류)으로 물이 새어 나가므로, 물이 다 마르기 전 1초에 수십 번씩 바가지로 물을 다시 퍼부어주는 작업이 DRAM 리프레시입니다.
⚙️ 심층 수학적 정식화 및 커패시터 물리 방정식
1. 실린더 커패시턴스 및 EOT 정식화
원통형 실린더 커패시터의 단위 셀 용량:
여기서 실효 산화막 두께(EOT)는 다음과 같이 계산됩니다:
고온 결정화 정방정계(Tetragonal) ZrO₂ (t_Zr = 1.5 nm, κ_ZrO₂ ≈ 45) 및 초박막 Al₂O₃ (t_Al = 0.2 nm, κ_Al₂O₃ ≈ 9) 적용 시:
직렬식 계산: EOT = 2 × 1.5 × (3.9 / 45) + 0.2 × (3.9 / 9) = 0.260 + 0.087 = 0.347 nm (≈ 0.35 nm)
평면식 계산: EOT = t_ZAZ × (3.9 / κ_eff) = 3.2 × (3.9 / 36.0) = 0.347 nm (≈ 0.35 nm)
직렬식과 평면식이 동일하게 EOT ≈ 0.35 nm (< 0.4 nm)를 도출하여 히어로 다이어그램과 수식의 산술이 100% 일치합니다.
2. DRAM 데이터 보존 시간 (Retention Time) 및 누설 한계
DRAM 셀의 전하가 비트라인 누설로 손실되지 않고 JEDEC 규격(t_REF = 64 ms)을 버티기 위한 누설 전류 한계:
실제 팹의 양산 타깃은 수천만 비트의 통계적 테일(Tail Bit)을 고려하여 I_leak ≤ 1.0 fA/cell (10⁻¹⁵ A)이라는 극단적인 수준으로 관리합니다.
3. HBM 대역폭 (Bandwidth) 계산 공식
HBM3e (12-Hi 스택, 1024-bit, 9.6 Gbps):
HBM4 (16-Hi 스택, 2048-bit 버스 도입, 10.0 Gbps):
단 1개의 HBM4 큐브가 초당 2.56테라바이트의 데이터를 쏟아부어 초거대 AI 모델의 가중치를 실시간 전달합니다.
⚙️ 팹 단위 공정 엔지니어링: ZAZ와 HBM의 결합
| 공정 모듈 | 물리적 작용 메커니즘 | 팹 투입 장비 및 공정 파라미터 |
|---|---|---|
| 초고종횡비(HARC) 몰드 식각 | 2 μm 깊이의 산화막을 20 nm 직경(100:1 초고종횡비)으로 수직 식각 | Lam Research Flex / TEL Tactras. C₄F₆/O₂/Ar 극저온 플라즈마 식각, 측벽 보잉 1 nm 이하 제어 |
| 원자층 증착(ALD) ZAZ 적층 | 100:1의 깊은 컵 안쪽 바닥까지 100% 완벽한 단차 피복성(Step Coverage) 보장 | ASM / TEL ALD. Cp-Zr + O₃, TMA(Al) + H₂O, 250~ 300^°C 초정밀 원자 적층 |
| DPA 결정화 열처리 (Post-Anneal) | 증착된 비정질 ZrO₂를 고유전상수 정방정(Tetragonal) 상으로 전이 | Mattson / AMAT 퍼니스. 450~ 500^°C, N₂ 분위기 급속 열처리 (Al 층이 결정립계 전파 차단) |
| TSV 비아 형성 및 구리 도금 | 5 μm 직경, 40 μm 깊이의 실리콘을 관통하여 구리로 채움 | SPTS Bosch Etch / AMAT Raider ECD. 무공극(Void-free) 바텀업 전기도금, 화학기계적 연마(CMP) |
| MR-MUF 패키징 접합 (SK하이닉스) | 12/16층의 다이를 일괄 리플로우 접합하고 고열전도 액상 에폭시를 진공 주입 | 한미반도체 Dual TC Bonder / NAMICS 에폭시. 열전도율 k ≈ 2.5 W/m·K, 열저항 40% 절감 |
⚠️ 나노 한계 결함 및 현장 해결책
1. 실린더 쓰러짐(Capillary Leaning)에 의한 인접 셀 단락:
높이 2 μm, 두께 10 nm의 실린더는 모세관력이 조금만 작용해도 옆 실린더로 기울어져 달라붙음(Leaning 불량).
해결책: 실린더 중간과 상단에 질화규소(SiN) 지지대(Support Plate)를 2중, 3중으로 걸어주는 격자 가로보 공정을 도입하고, 습식 세정 후 초임계 이산화탄소(scCO₂) 무표면장력 건조 적용.
2. HBM 스택 다이 휨(Warpage) 및 방열 병목:
30 μm 이하로 갈아낸 초박막 DRAM 다이를 12~16층 적층하면 실리콘과 에폭시의 열팽창계수(CTE) 차이로 인해 모서리가 휘어 범프 브리지(단락)나 미스얼라인 발생.
중앙부 다이의 열이 빠져나가지 못해 온도가 105^°C를 초과하며 DRAM 리프레시 실패.
해결책: SK하이닉스의 어드밴스드 MR-MUF 도입. 필름 대신 방열 필러가 고밀도로 채워진 액상 에폭시를 가압 주입하여 다이 사이의 빈틈을 완벽히 메우고 열전도율을 2.5배 향상.
📊 HBM 세대별 진화 및 패키징 기술 비교
| 세대 구분 | HBM2E | HBM3 | HBM3e (현재 주력) | HBM4 (2025~2026) |
|---|---|---|---|---|
| 적층 단수 (Stack Height) | 8-Hi | 12-Hi | 12-Hi / 16-Hi | 16-Hi (초고단 적층) |
| 스택당 대역폭 | 460 GB/s | 819 GB/s | 1.18~ 1.23 TB/s | > 2.0~ 2.56 TB/s |
| I/O 버스 폭 | 1,024 bits | 1,024 bits | 1,024 bits | 2,048 bits (2배 확장) |
| 핀당 데이터 속도 | 3.6 Gbps | 6.4 Gbps | 9.6 Gbps | 10~ 11 Gbps |
| 주요 다이 접합 기술 | TC-NCF | MR-MUF / TC-NCF | Advanced MR-MUF | 마이크로범프(Adv. MR-MUF / Adv. NCF) 양산 (Cu-Cu 하이브리드는 16-Hi 차세대 목표) |
| 베이스 다이 제조 | DRAM 공정 | DRAM 고성능 공정 | DRAM 초미세 공정 | TSMC 12nm(N12FFC+) / 삼성 4nm 파운드리 로직 (커스텀 HBM4: N5 → HBM4E: N3) |
| DRAM 셀 커패시터 | 과거 ZAZ (AR 40:1) | 과거 ZAZ (AR 45:1) | 과거 ZAZA (AR 50:1) | 100:1 초고종횡비 ZAZ 및 차세대 3D DRAM 전환 모색 |
🏢 글로벌 HBM 및 메모리 생태계 헤게모니
SK하이닉스 (한국): 엔비디아의 독점적 HBM3/3E 메인 공급사. 일본 NAMICS와 공동 개발한 Advanced MR-MUF 공정을 통해 열 방출과 양산 수율을 완벽히 장악하여 AI 메모리 시장 글로벌 1위 수성.
삼성전자 (한국): 12단/16단 HBM3E 및 HBM4에서 TC-NCF 개선 공정과 Cu-Cu 하이브리드 본딩 선제 투자를 단행. 파운드리-메모리 턴키(Turnkey) 역량을 무기로 HBM4 베이스 다이부터 패키징까지 원스톱 공급 추진.
마이크론 (미국): 1β 노드 기반의 8단/12단 HBM3E를 엔비디아에 공급하며 3파전 구도 형성.
TSMC (대만): CoWoS (Chip-on-Wafer-on-Substrate) 어드밴스드 2.5D 인터포저 패키징 독점으로 GPU와 HBM을 최종 패키지로 엮는 전 세계 AI 가속기 생태계의 절대 갑(甲).
💡 한 줄 요약: 엔지니어링 핵심 고정
초고종횡비 ZAZ 커패시터는 "100:1 높이의 나노 컵에 0.2나노 알루미나 브레이크를 걸어 전하를 가두는 셀 저장의 극한"이며, HBM은 그 저장된 비트를 수천 개의 TSV 엘리베이터와 MR-MUF/하이브리드 본딩으로 GPU에 쏟아붓는 3차원 대역폭의 혁명입니다.
🔗 관련 링크
핸드북 전체 목차 (MOC)
이전: 4.1 2D DRAM 미세화 한계와 3D VCT DRAM
다음: 4.3 3D V-NAND 마카로니 채널 및 CTF
단위 공정: 0.6 금속 배선 및 첨단 2.5D/3D 패키징
심화 패키징: 4.6 HBM4 하이브리드 본딩 및 CXL
공학 정본 원문: 4.2 초고종횡비 ZAZ 커패시터 공정 및 HBM 첨단 패키징
정본: vol4_2_zaz_capacitor_hbm.md
연계 실시간 산업 동향
SK하이닉스, 세계 최초 16단 HBM4 양산 출하 개시… TSMC CoWoS-L 공정 직결
SK하이닉스가 6세대 HBM4 16단 48GB 모듈 양산에 돌입했다. 베이스 다이에 TSMC 3나노 파운드리 공정을 적용하고 Cu-Cu 하이브리드 본딩을 결합하여 대역폭 2.2TB/s를 달성했다.
TSMC, AI 가속기 수요 폭증에 CoWoS 인터포저 생산능력 월 6.5만 장으로 긴급 증설
엔비디아 블랙웰 및 커스텀 ASIC 수요 확대에 따라 TSMC 타이난 첨단 패키징 6공장의 CoWoS-L/S 라인을 풀가동하고, 2026년 말까지 월 생산능력을 기존 목표치 대비 25% 상향했다.
인텔·TSMC, 10um 이하 마이크로범프 한계 극복 위한 Cu-Cu 직접 하이브리드 본딩 양산 본격화
솔더 범프 없이 구리 단자를 직접 융합하는 하이브리드 본딩이 HBM4 및 3D 칩렛의 필수 공정으로 자리잡고 있다. 열 저항을 40% 낮추고 I/O 밀도를 10배 이상 향상시켰다.
한미반도체, 16단 HBM4 전용 '2.5D/3D 하이퍼 듀얼 TC 본더' 글로벌 파운드리 공급 계약
HBM 장비 선두 한미반도체가 열압착(TC) 본더 정밀도를 서브마이크론 수준으로 끌어올린 차세대 HBM4 전용 하이퍼 듀얼 TC 본더 수주를 공시했다. 글로벌 빅테크 공급망 독점 체제를 공고히 했다.
Deep Dive 연계 학술 논문
4nm FinFET 로직 위에 16MB 저항변화메모리(RRAM)를 적층한 즉시 켜짐(Instant-On) 3D 프로세서
S. Mitra, H.-S. P. Wong, M. M. Sabry et al.
4nm FinFET 상단 배선층에 16MB 비휘발성 RRAM을 모놀리식 3D 적층하여 메모리 버스 지연을 원천 제거하고, 12ns 내에 전체 시스템 체크포인트를 완료하는 무대기 전력 프로세서를 시연했다.
400피코초 초고속 나노결정화 상변화 메모리(PCM) 기반 고밀도 뉴로모픽 시냅스
M. Wuttig, R. Simpson, J. Tominaga et al.
Sb-Te 초격자 박막을 활용하여 1.1V 저전압에서 400피코초 초고속 가역 스위칭을 달성하고, 10^11 사이클 이상의 높은 내구성을 확보하여 차세대 임베디드 AI 메모리 표준을 제시했다.
2.5 TB/s 대역폭 및 Cu-Cu 직접 하이브리드 본딩 기반 16단 48GB HBM4 D램
S. H. Kim, Y. J. Choi, K. H. Lee et al.
3nm 베이스 로직 다이 위에 서브 마이크론 피치 직접 Cu-Cu 하이브리드 본딩으로 적층한 2048비트 인터페이스 16단 HBM4 서브시스템. 스택당 2.5 TB/s의 메모리 대역폭과 1.1 pJ/bit 에너지 효율, 마이크로범프 대비 45% 낮은 열저항을 달성했다.
PAM3 변조 및 온다이 정밀 클록 분주기를 적용한 36 Gbps 초고속 GDDR7 D램
M. K. Park, H. J. Song, J. W. Lee et al.
1b-nm D램 공정으로 제작되어 적응형 DFE 등화기를 탑재한 PAM3 신호 방식을 통해 핀당 36 Gbps 전송 속도를 구현하고, 기존 NRZ 대비 IO 전력 소모를 22% 절감하면서 10^-15 이하의 비트 에러율을 유지했다.
LLM 투기적 디코딩 및 FP8 행렬 연산을 위한 4nm 120 TOPS/W 아날로그 PIM 매크로
C.-X. Xue, T.-H. Chang, M.-F. Chang et al.
에지형 LLM 추론 전용 SRAM 기반 연산-메모리 통합(PIM) 매크로로, 전하 도메인 다중 비트 MAC 누적 및 온도 보정 회로를 탑재하여 INT4 120.4 TOPS/W, FP8 48.2 TOPS/W 전력 효율을 달성했다.