평면 CMOS 8대 표준 제조 공정 플로우
Planar CMOS 8-Step Integration Flow
웰 형성부터 실리사이드 접촉 및 다층 금속 배선까지의 전공정
2.5 평면 CMOS 표준 제조 공정 플로우 — 웨이퍼 한 장이 트랜지스터 수십억 개가 되기까지
💡 3초 핵심 요약
평면 CMOS 플로우는 흰 도화지(웨이퍼) 위에 같은 레시피로 수천만 번 도장을 찍어, NMOS와 PMOS를 나란히 심고, 그 위에 구리 전선 도시를 쌓는 일이다. 한 채의 집을 짓는 순서가 기초 → 기둥 → 지붕 → 배관이듯, 칩도 격리 → 게이트 → 소스/드레인 → 콘택 → 배선 → 보호막의 순서를 절대 바꾸지 않는다. 순서가 바뀌면 집이 무너지듯, 열 예산과 계면이 한꺼번에 무너진다.
일상 비유로는 초고층 아파트 시공이 가장 정확하다.
웨이퍼 = 대지
STI = 세대 사이 방화벽
게이트 = 현관 도어락 (전압으로 문을 연다)
소스/드레인 = 거실과 주방
콘택/비아 = 엘리베이터 샤프트
금속층 = 층별 복도와 도로
패시베이션/RDL = 외벽과 옥상 배관
한 세대(노드)의 레시피는 약 400~1,000 스텝, 마스크는 로직 평면 전성기 기준 30~50장, 사이클 타임은 8~16주. 그 전체가 “평면 CMOS 표준 플로우”다.
🎨 눈으로 보는 핵심 구조도
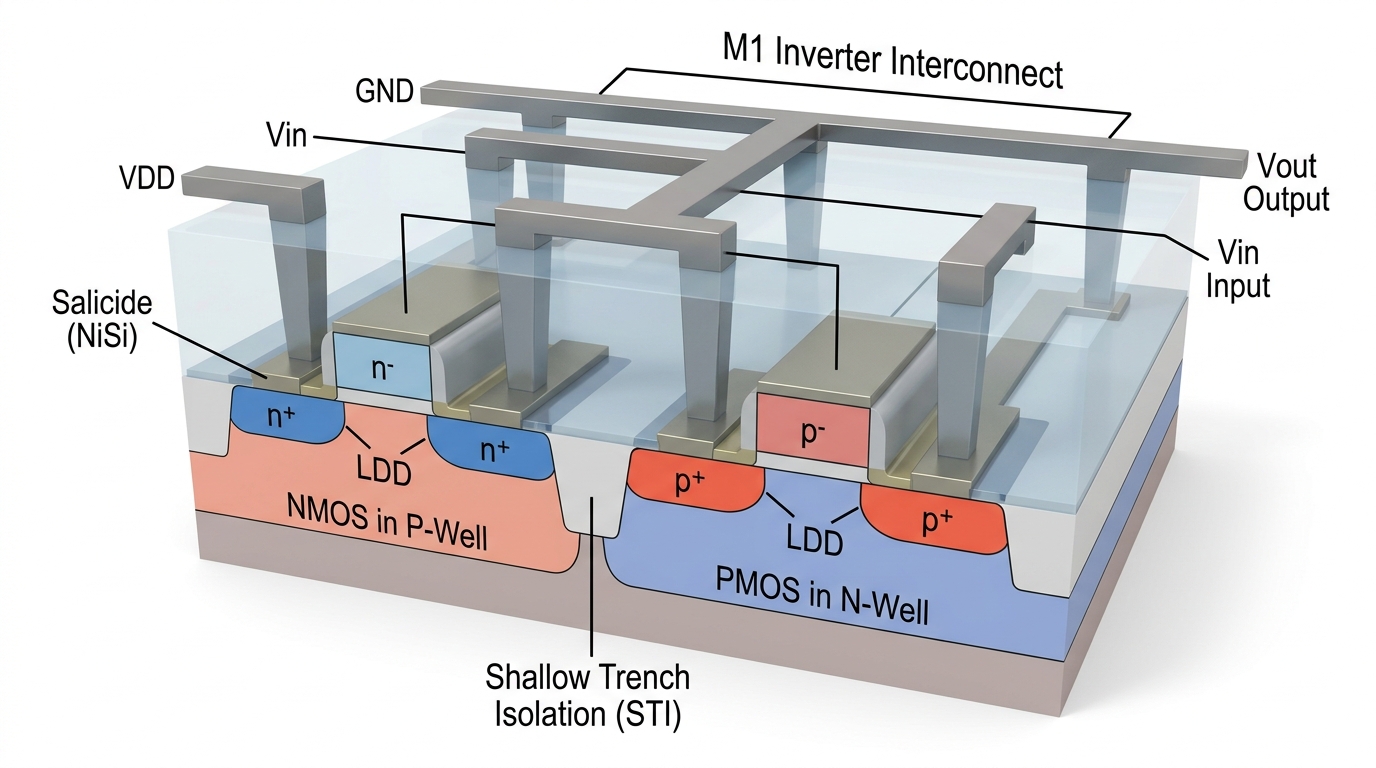
💡 [3D 공학 정밀 구조도] 트윈웰(Twin-Well) 평면형 CMOS 인버터 단면 구조: NMOS/PMOS 웰 격리, 살리사이드 및 M1 상호연결
🎨 눈으로 보는 핵심 소자 구조도 (정밀 단면도 & 머메이드 다이어그램)
| 제조 계층 단계 | 주요 형성 박막 및 배선 구조 | 사용 소재 및 인터커넥트 물성 | 공정 온도 및 핵심 제약 |
|---|---|---|---|
| 최상부 보호층 | Passivation (SiN + Polyimide PI) | 칩 물리적 충격 및 습기 차단 | 저온 열처리 (< 350^°C) |
| 글로벌 배선 (BEOL M3) | 최상부 후막 Cu 배선 + Low-k 절연막 | 초저저항 전원망(VDD/VSS) 구축 | 구리 확산 방지용 TaN/Ta 라이너 |
| 비아 콘택 (Via2, Via1) | 상하부 배선 직결 비아 플러그 | 듀얼 다마신 전기 도금 Cu 충진 | 층간 정렬 오차(Overlay) < 2 nm |
| 로컬 배선 (BEOL M1) | 미세 피치 금속 배선 | 표준 로직 셀 내부 고속 라우팅 | 기생 정전용량 최소화 |
| MOL 연결 콘택 | Middle of Line (M0 / Contact Plug) | 텅스텐(W), 코발트(Co), 루테늄(Ru) | 450^°C 이하 엄격한 열 예산 준수 |
| FEOL 게이트 스택 | HKMG (High-k Gate Dielectric + Metal) | HfO₂ + TiN/TaN 일함수 금속 | 원자층 단위 두께 제어 (< 1.5 nm) |
| FEOL 소스/드레인 | Embedded SiGe (pMOS) / Si:P (nMOS) | 선택적 에피택시 성장(SEG) 단결정 | 인장/압축 채널 스트레인 인가 |
| 소자 분리 격리막 | STI (Shallow Trench Isolation) | 고종횡비 트렌치 SiO₂ 갭필 매립 | 소자 간 래치업 및 누설 방지 완전 절연 |
같은 웨이퍼에 왼쪽은 NMOS, 오른쪽은 PMOS. 가운데 STI가 둘을 전기적으로 갈라 놓고, 위로는 콘택 → M1 → via → M2…가 도시를 만든다. 평면 CMOS의 본질은 채널이 웨이퍼 표면에 납작하게 누워 있다는 점이다. FinFET처럼 채널을 세워 올리지 않는다.
1. 평면 CMOS 제조 4대 핵심 국면 비교 (4 Critical Milestones)
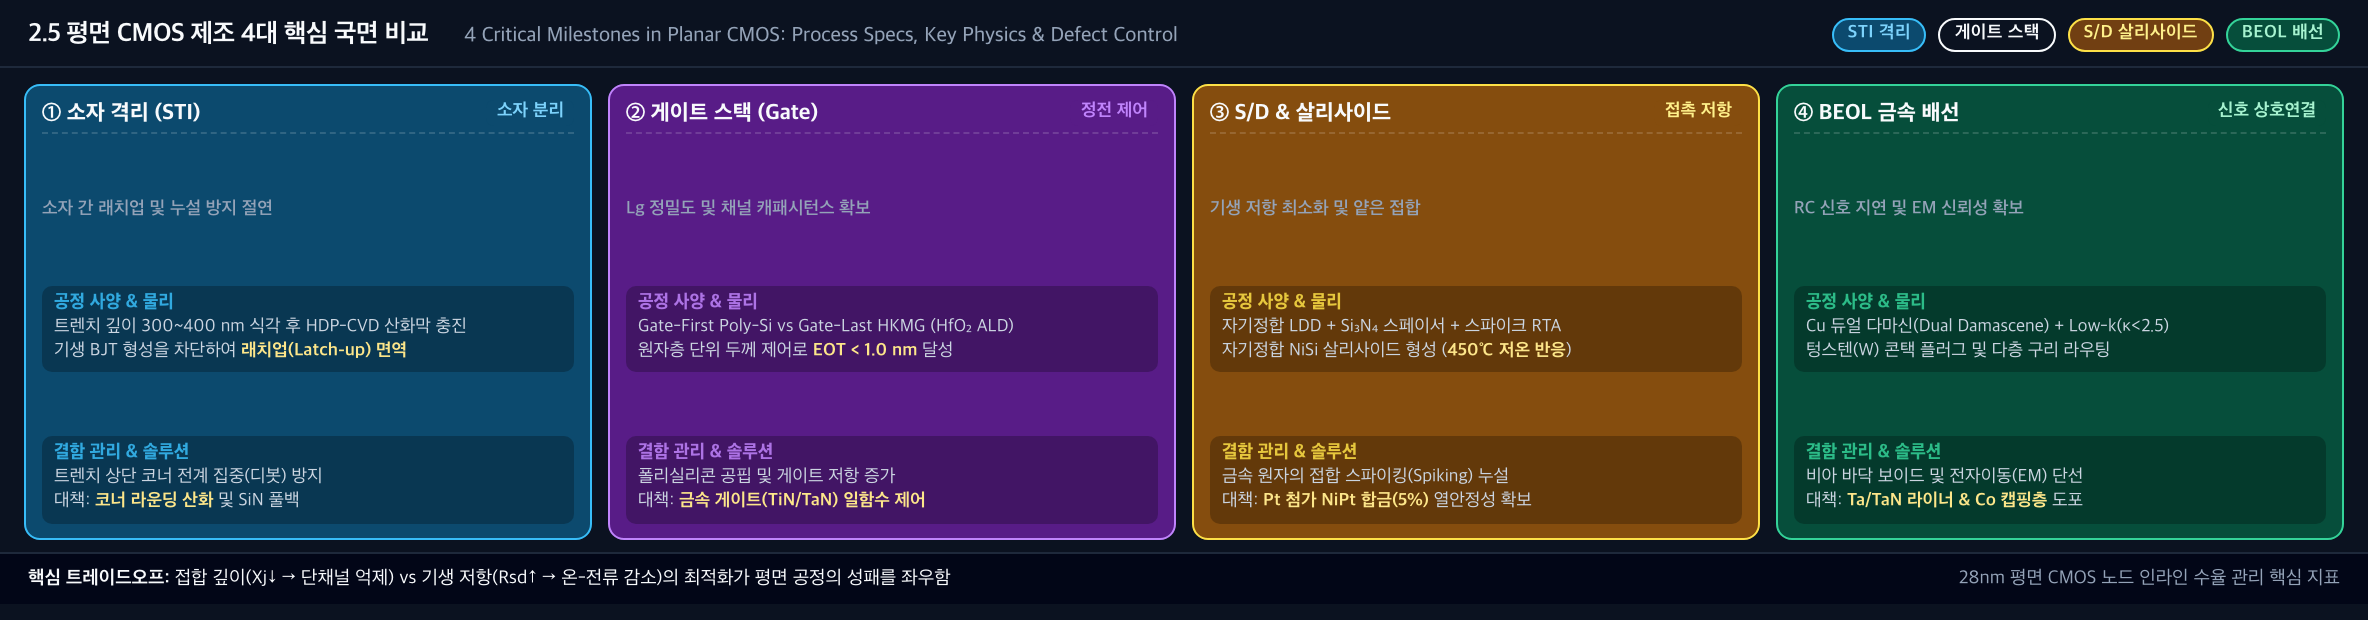
💡 [평면 CMOS 제조 4대 핵심 국면 비교 배너] STI 소자 격리 vs 게이트 스택 엔지니어링 vs S/D 및 살리사이드 vs BEOL 금속 배선
*<b>💡 [평면 CMOS 제조 4대 핵심 국면 비교 배너] 공정 사양, 소자 물리, 결함 관리 솔루션 및 파운드리 수율 관리 지표 대조</b>*
2. 평면 CMOS 기술 패러다임 진화사 (1980s ~ 2011)
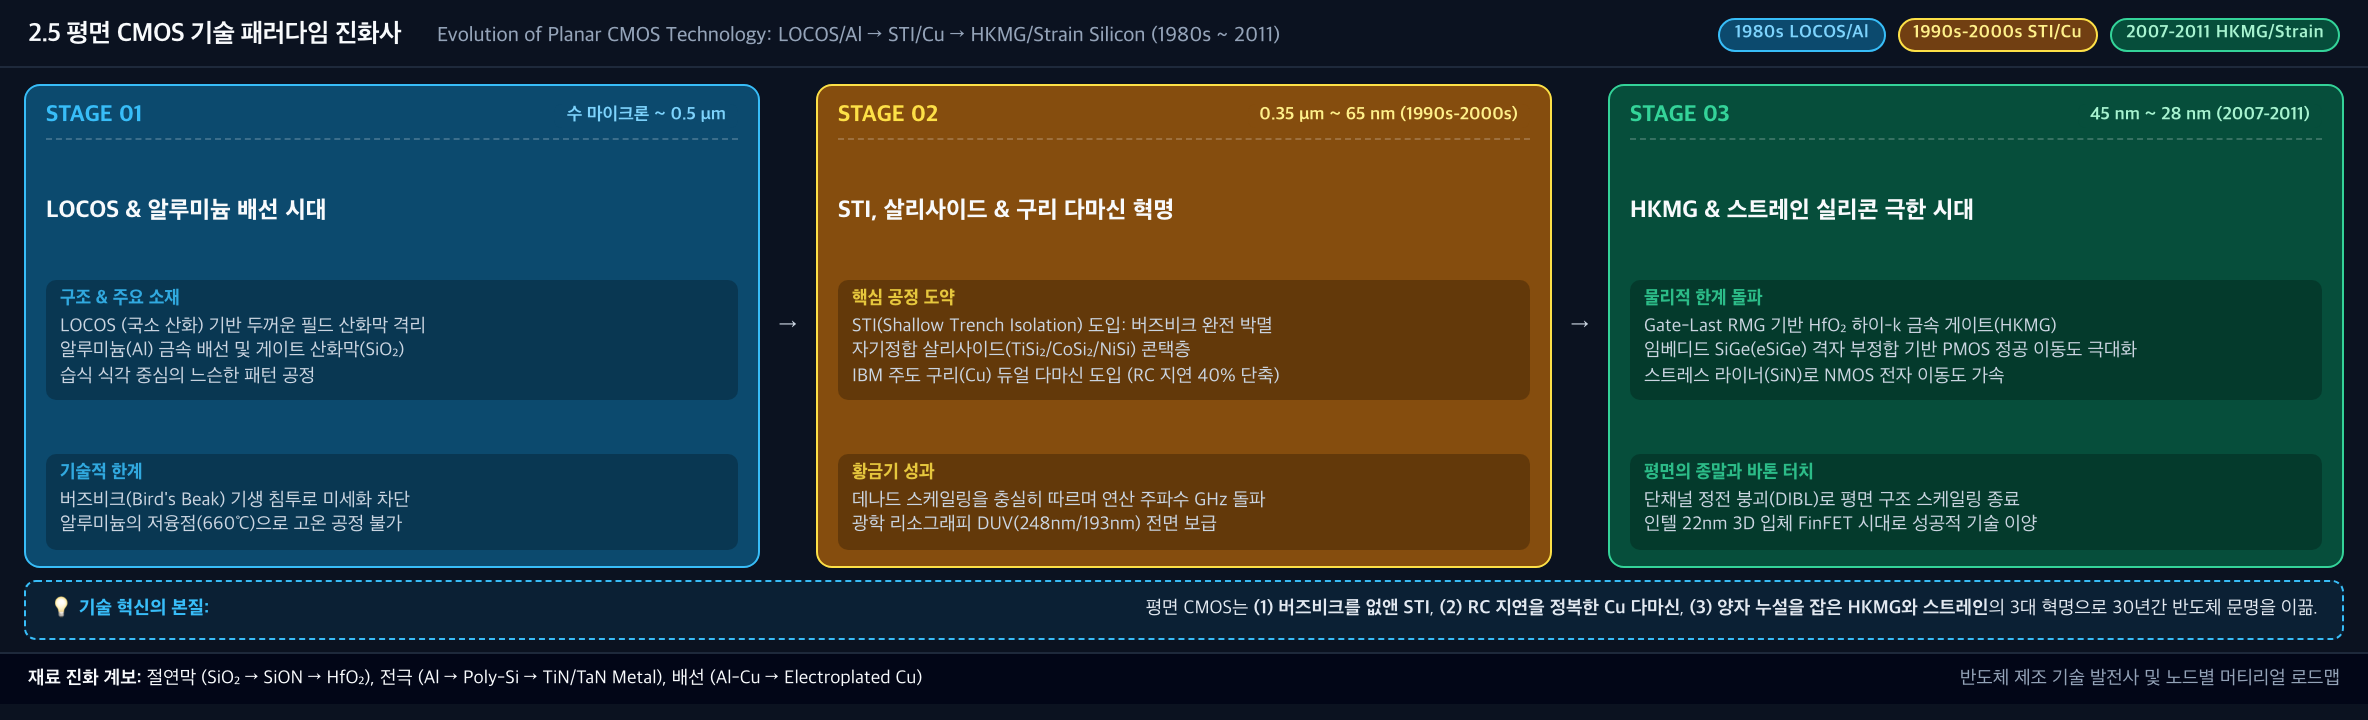
💡 [평면 CMOS 기술 패러다임 진화사 인포그래픽] 1980s LOCOS/Al 시대 → 1990s-2000s STI/살리사이드/Cu 다마신 혁명 → 2007-2011 HKMG/스트레인 실리콘 극한 시대
*<b>💡 [평면 CMOS 기술 패러다임 진화사 인포그래픽] 버즈비크를 박멸한 STI, RC 지연을 극복한 Cu 다마신, 양자 터널링을 정복한 HKMG/스트레인 3대 혁신 연대기</b>*
3. 평면 CMOS 표준 집적 공정 전체 시퀀스 & 수율 보증 폐루프 (FEOL → MOL → BEOL)
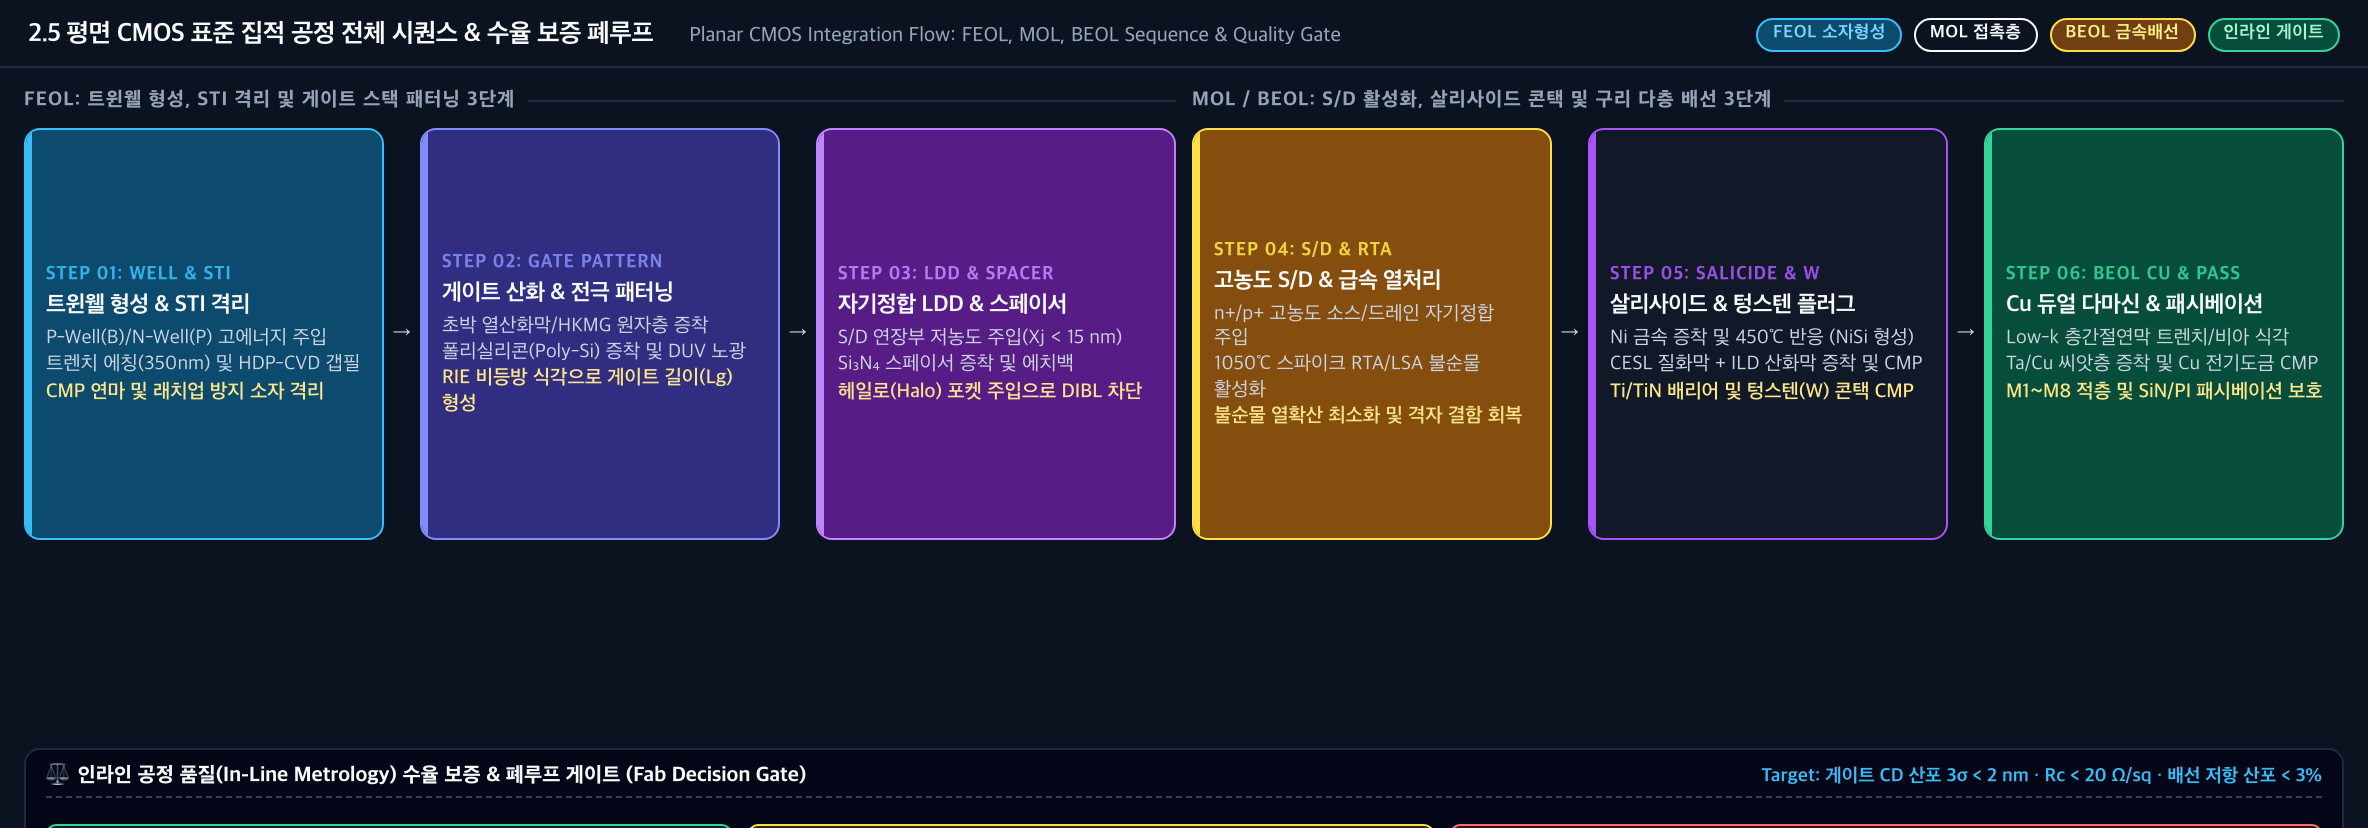
💡 [평면 CMOS 집적 공정 전체 시퀀스 및 수율 보증 폐루프] 트윈웰/STI → 게이트 패터닝 → LDD/스페이서 → S/D RTA → NiSi 살리사이드 → Cu 다마신 배선
*<b>💡 [평면 CMOS 집적 공정 전체 시퀀스 및 수율 보증 폐루프] 열 예산(Thermal Budget) 하향 준수, CD 3σ < 2nm, Rc < 20 Ω/sq 인라인 수율 보증 게이트</b>*
4. 평면 CMOS 4대 공정 불량 및 수율 극복 솔루션 트리
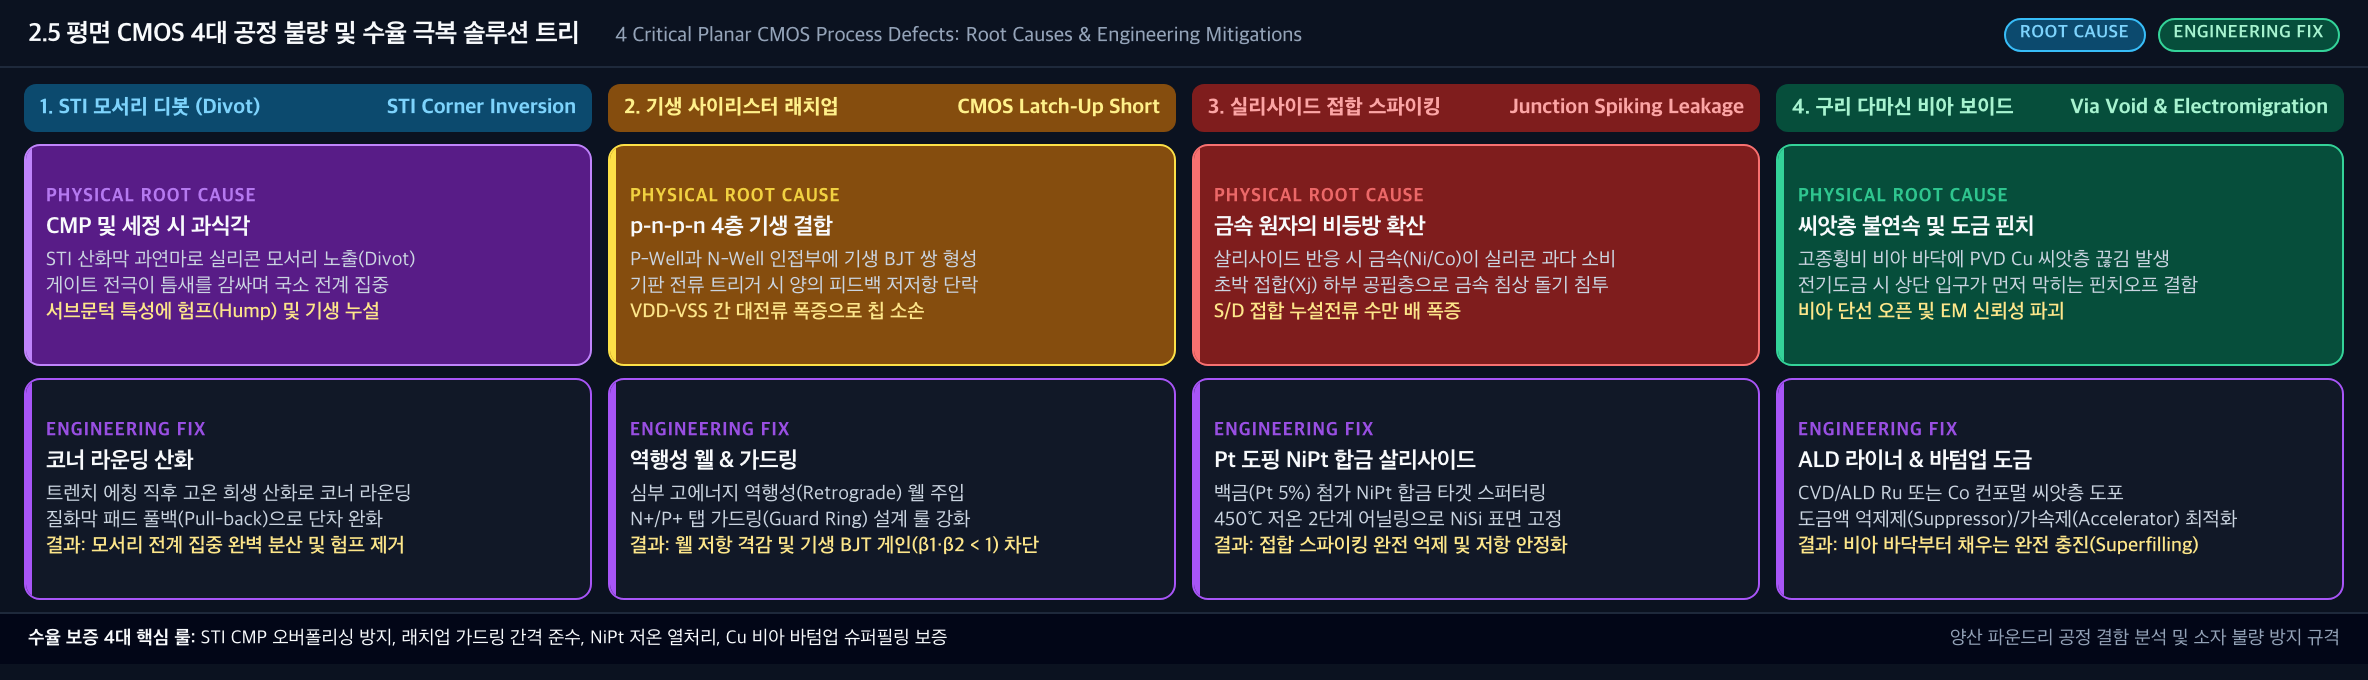
💡 [평면 CMOS 4대 공정 불량 및 수율 극복 솔루션 트리] STI 모서리 디봇 · 기생 사이리스터 래치업 · 살리사이드 스파이킹 · Cu 다마신 비아 보이드 해결 트리
*<b>💡 [평면 CMOS 4대 공정 불량 및 수율 극복 솔루션 트리] 근본 물리 원인(Root Cause)과 파운드리 엔지니어링 대책(Engineering Fix) 1:1 매칭 해결 트리</b>*
현장 언어로 나누면:
| 구간 | 별칭 | 하는 일 | 대표 장비 |
|---|---|---|---|
| FEOL | Front End Of Line | 트랜지스터를 만든다 | 이온주입기, 산화로, 게이트 식각, RTA |
| MOL | Middle Of Line | 트랜지스터를 세상에 연결 | 콘택 식각, W CVD, CMP |
| BEOL | Back End Of Line | 전선 도시를 쌓는다 | Cu 도금, 저유전 증착, CMP, 리소 |
| Far BEOL | 패키지 직전 | 패드, RDL, 범프 | PI 코팅, UBM, 플레이팅 |
🔍 왜 필요한가? — “아무렇게나 쌓으면 트랜지스터가 안 된다”
1950~60년대 바이폴라는 한 소자씩 손으로 조립에 가까웠다. 평면 공정(Fairchild, 1959 Noyce / Hoerni)이 열어 준 혁명은 같은 마스크 세트로 웨이퍼 전면을 한꺼번에 복제하는 일이었다. CMOS가 표준이 된 이유는 단순하다.
1. 대기 전력이 거의 0에 가깝다. NMOS나 PMOS 단독 로직은 항상 전류가 샌다. CMOS 인버터는 한쪽이 꺼지면 다른 쪽이 켜져, DC 경로가 끊긴다. 스마트폰이 하루를 버티는 물리적 이유다. 2. 노이즈 마진이 크다. 디지털 0/1이 레일-투-레일로 선다. 3. 집적도가 스케일된다. Dennard 스케일링 시대(대략 1 µm → 90 nm)에는 게이트를 줄이면 속도↑, 전력↓, 밀도↑가 동시에 왔다.
그런데 평면 CMOS가 “표준 플로우”로 굳어진 더 중요한 이유는 열 예산(thermal budget) 이다.
게이트 산화막은 고온을 좋아한다 (계면 결함↓).
소스/드레인 접합은 고온을 싫어한다 (도펀트가 옆으로 퍼져 채널이 짧아진다, SCE).
구리 배선은 400 °C 이상에서 확산해 실리콘을 독살한다.
salicide는 너무 뜨거우면 뭉치고(agglomeration), 너무 차가우면 저항이 남는다.
그래서 순서는 종교에 가깝다.
90 nm 이후 평면은 누설과 단채널에 무릎을 꿇고 FinFET으로 넘어간다. 하지만 레거시 로직, 아날로그, HV, MCU, CIS 로직부, 디스플레이 드라이버, 자동차 12 V/40 V 소자는 지금도 180~28 nm 평면 CMOS가 주력이다. “구세대”가 아니라 돈과 신뢰성이 가장 많이 도는 플로우다.
📐 이론을 지탱하는 3대 수식과 직관적 물리
CMOS 표준 공정 순서는 우연히 정해진 것이 아니라, 열확산 역학, 기생 사이리스터 결합 제어, 양자역학적 터널링 접촉이라는 3대 물리 원칙에 의해 필연적으로 설계되었다.
[수식 1] 열 예산(Thermal Budget)과 도판트 확산 거리 수식
웨이퍼가 고온 열처리 공정(T)에 시간 t 동안 노출될 때, 주입된 도판트 원자가 확산하여 넓어지는 접합 깊이(Junction Depth, x_j)는 아레니우스 확산 방정식으로 결정된다:
D₀: 고유 확산 계수, E_a: 확산 활성화 에너지 (보론 B의 경우 실리콘 내 E_a ≈ 3.5 eV)
kB: 볼츠만 상수, T: 절대 온도 (K)
| 공정 영역 | 최고 공정 온도 | 주요 적용 단위 공정 | 열 예산(Thermal Budget) 엔지니어링 원칙 |
|---|---|---|---|
| FEOL 기판/격리 단계 | 900~ 1050^°C (최고온) | STI 산화막 치밀화, 웰 불순물 드라이브인, 스파이크 RTA | 트랜지스터 구조물이 없으므로 고온 결함 치유 및 결정화 가능 |
| FEOL 소스/드레인 단계 | 550~ 750^°C (중고온) | 선택적 에피택시 성장(SiGe SEG), 실리사이드 형성(NiPtSi) | 도펀트 원자의 과도한 열확산(Dt)을 억제하여 얕은 접합(USJ) 보존 |
| MOL / BEOL 배선 단계 | ≤ 400~ 450^°C (저온 한계선) | 콘택 플러그(W), 구리 배선, Low-k 층간 절연막 증착 | 구리 원자 확산 및 Low-k 절연막 파괴 방지를 위한 절대 마지노선 |
공정 순서의 절대 법칙 (되돌릴 수 없는 시간의 화살):
게이트 산화막 성장(~ 1000^°C)을 먼저 끝내고, 소스/드레인 주입 후에는 도판트가 채널 쪽으로 번져 들어가지 않도록 극초단 스파이크 RTA(~ 1050^°C, 1초)로만 열을 가한다.
살리사이드(NiSi, 400~ 500^°C)와 백엔드 Cu 배선(<400^°C)이 들어선 후에는 절대 고온을 가할 수 없다. 만약 순서를 어기고 Cu 배선 후 고온 열처리를 하면, 구리 원자가 실리콘 채널로 번져 들어가 트랜지스터를 즉사시킨다.
[수식 2] 래치업(Latch-up) 방지 기생 BJT 이득 곱 수식
동일 기판 위에 NMOS와 PMOS가 인접 배치될 때 필연적으로 기생 p-n-p (p+소스 - n웰 - p기판) 트랜지스터와 n-p-n (n웰 - p기판 - n+소스) 트랜지스터가 형성되어 4층 사이리스터(p-n-p-n)를 이룬다.
이 기생 사이리스터가 켜져 전원(VDD)과 접지(VSS) 사이에 단락 전류가 폭주하는 현상이 래치업(Latch-up)이며, 이를 방지하기 위한 절대 안정 조건은 다음과 같다:
flowchart TD
    subgraph CMOSLatchup ["CMOS 인버터 래치업(Latch-up) 물리 메커니즘"]
        Q1["기생 NPN 트랜지스터 (N+ 소스 - P 기판 - N 웰)"] <-->|기판 저항 R_sub 및 웰 저항 R_well 통한 정귀환 루프| Q2["기생 PNP 트랜지스터 (P+ 소스 - N 웰 - P 기판)"]
        Q1 --> TR["정귀환(Positive Feedback) 발생 시 대전류가 VDD에서 VSS로 쇼트 폭주 (칩 영구 소손!)"]
    end
    subgraph STISolution ["STI 격리 및 가드링을 통한 원천 방어"]
        S1["깊은 STI 절연 트렌치 형성: NPN/PNP 간 캐리어 이동 경로 물리적 차단"]
        S2["고농도 탭(Well Tap / Sub Tap) 배치: 기판 및 웰 저항을 0에 가깝게 낮춰 전위차 억제"]
        S1 --> OK["래치업 면역성 100% 확보"]
        S2 --> OK
    end
팹 엔지니어의 방화벽 처방:
두 기생 바이폴라의 전류 이득 곱을 1 미만으로 떨어뜨리기 위해, 두 소자 사이에 깊은 STI(깊이 300~ 400 nm)를 파서 베이스 폭을 물리적으로 늘리고, 웰 탭(Well Tap) 가드링을 촘촘히 배치하여 기생 저항에 의한 전압 강하를 억제한다.
[수식 3] 콘택 비저항(Specific Contact Resistivity ρ_c)과 살리사이드
금속 전선과 실리콘 소스/드레인이 만나는 계면에서 캐리어는 쇼트키 장벽(Schottky Barrier Height, Φ_B)을 뚫고 지나가야 한다. 고농도 축퇴 도핑(ND > 10²⁰ cm⁻³) 시 장벽이 극도로 얇아져 양자역학적 전계 방출(Field Emission / 터널링)이 일어나며, 이때 콘택 비저항 ρ_c는 다음과 같다:
실리사이드(Salicide: NiSi)의 마법:
실리콘에 직접 금속을 대면 높은 장벽(Φ_B ≈ 0.7 eV)으로 저항이 폭증한다.
소스/드레인 표면에 니켈(Ni)을 증착하고 열처리하여 자가정합 니켈 실리사이드(NiSi)를 형성하면 Φ_B가 p-Si 기준 ~0.45 eV(n-Si ~0.65 eV)로 낮아지고 표면 캐리어 밀도(ND)가 극대화되어, 콘택 저항을 10⁻⁹ Ω·cm² 이하로 낮출 수 있다.
⚙️ 심층 작동 메커니즘 & 팹 단위 공정 — 한 장의 웨이퍼가 걷는 길
아래는 로직 파운드리 기준 28~65 nm 평면 HKMG 또는 Poly/SiON 을 염두에 둔 표준 레시피다. DRAM은 커패시터 모듈이 끼어 들고, NAND는 셀 어레이가 3D로 올라가지만, 주변 로직(peri)은 여전히 이 뼈대다.
0) 웨이퍼 — 도화지의 품질이 수율을 결정한다
재료: CZ p-type Si, 300 mm, 결정면 (100), 비저항 수~수십 Ω·cm.
에피: p/p+ 에피 2~5 µm. 기판의 산소·금속 불순물을 채널에서 멀리 둔다.
사전 세정: SC-1 (NH4OH/H2O2/H2O) 파티클, SC-2 (HCl/H2O2) 금속, DHF로 자연산화막 제거.
현장 감각: 이 단계의 금속 오염 1×10^10 atoms/cm²만 나와도 게이트 산화막 GOI가 무너진다. 세정조 수명, 린스 비저항, 건조 마란고니(IPA)가 수율의 바닥이다.
1) STI — 이웃집 화재를 막는 방화벽
평면 CMOS의 첫 구조 공정.
flowchart LR
    S1["[1] 패드 산화막 & 질화막<br/>Pad Oxide + SiN 하드마스크 증착"] --> S2["[2] 트렌치 비등방 식각<br/>깊이 250~400 nm 건식 RIE 식각"]
    S2 --> S3["[3] 열산화 라이너 성장<br/>모서리 라운딩 및 계면 결함 완화"]
    S3 --> S4["[4] 고밀도 플라즈마 갭필<br/>HDPCVD / HARP SiO2 완전 매립"]
    S4 --> S5["[5] 화학기계적 연마<br/>CMP로 SiN 정지 후 스트립"]
    S5 --> S6["[6] 희생 산화 및 세정<br/>원자 평탄 활성 영역 노출"]
왜 로코스(LOCOS)를 버렸나? 버즈빅(bird’s beak)이 활성 면적을 잡아먹어 0.25 µm 이하에서 밀도 자살이었다. STI는 수직 벽을 깎아 면적을 도둑질하지 않는다.
현장 불량:
갭필 보이드 → 폴리 잔류 → 브리지.
CMP 디싱 → 이후 게이트 CD 흔들림.
STI 코너의 전계 집중 → 험프, 누설. 라이너 산화와 코너 라운딩이 약이다.
장비: AMAT / Lam ICP 트렌치, Applied HDP, Ebara/AMAT CMP.
2) 웰과 Vt 조절 — 땅의 도핑을 심다
트윈 웰: NMOS는 p-well, PMOS는 n-well.
트리플 웰: 노이즈 민감 아날로그, SRAM, HV 분리.
이온주입: B, BF2, P, As, In, Sb. 에너지 keV~수백 keV, 도즈 1e12~1e14 cm^-2.
포토레지스트가 마스크. 웰 마스크는 정렬 오차가 게이트보다 관대하지만, 래치업 가드링 폭을 잡아먹는다.
비유: 밭에 산성 흙(p-well)과 알칼리 흙(n-well) 을 구역별로 뿌리는 일. 나중에 심을 작물(전자/정공 채널)이 달라진다.
채널 스톱 / 펀치스루 스톱 주입을 STI 바로 밑, 채널 밑에 넣어 기생 NMOS와 펀치스루를 막는다.
3) 게이트 스택 — 현관문과 문틀
클래식 (90 nm 이상, 그리고 많은 레거시):
건식/습식 산화, 800~900 °C, EOT 1.2~2.0 nm급 SiO2 또는 SiON (NO/N2O 질화로 보론 침투 억제).
폴리실리콘 CVD, 100~150 nm, N+/P+ Dual poly (NMOS는 P 또는 As, PMOS는 B).
문제: 폴리 공핍(poly depletion)이 EOT를 0.3~0.5 nm 허비한다. 보론 관통은 PMOS NBTI와 Vt 시프트.
HKMG (45/32/28 nm 평면 전성기):
계면 SiO2 수 Å + HfO2(또는 HfSiON) ALD.
게이트 퍼스트: 금속(TiN 등)을 먼저 올리고 고온 어닐.
게이트 라스트(replacement metal gate): 더미 폴리를 나중에 파내고 일함수 금속을 채움. NMOS용 낮은 일함수, PMOS용 높은 일함수를 두 번 증착한다.
리소: 게이트는 스캐너 인생의 꽃. 193 nm 이머전, 강한 OPC, 더블 패터닝 직전 세대까지 평면이 끌고 갔다. 게이트 CD 1 nm가 칩 속도 수 %다.
식각: 폴리/메탈 게이트는 이방성, 하드마스크, 아주 얇은 산화막에서 멈춰야 한다. 펀치스루 식각은 채널을 죽인다.
4) 스페이서와 확장 접합 — 문 옆의 완충 지대
게이트를 세운 뒤 바로 깊은 소스/드레인을 박으면, 도펀트가 게이트 밑으로 기어들어 유효 채널이 사라진다.
그래서 순서는:
1. LDD / Extension 얕은 주입 (As, P, BF2, C 공주입). 2. Halo / Pocket 경사 주입으로 채널 가장자리를 조금 더 세게 도핑 → SCE 억제. 3. 스페이서 SiN 또는 SiN/SiO2 복합, CVD 후 이방성 에치백. 폭 20~50 nm가 곧 확장 길이. 4. 깊은 S/D 고도즈. 5. 활성화: Spike RTA 1000~1050 °C, 1초 미만. 또는 레이저 스파이크(LSA)로 표면만 녹이다시피 가열. 정션은 얕게, 활성화는 높게 — 모순을 장비로 푼다.
비유: 현관 앞에 짧은 지붕(스페이서) 을 달아, 빗물(도펀트)이 거실(채널)로 들이치지 않게 한다.
5) 살리사이드 — 실리콘 위에 금속 양복을 입히다
노출된 게이트 폴리와 S/D 실리콘 위에 Ti, Co, 또는 Ni 을 스퍼터하고 어닐하면 자기정합 실리사이드가 생긴다. 산화물 위에서는 반응이 안 일어나 스페이서가 자연 마스크가 된다. 그래서 self-aligned silicide = salicide.
0.25~0.13 µm: CoSi2
90~28 nm: NiSi (라인 저항↓, 실리콘 소비↓). NiPtSi로 열안정.
실패 모드: 좁은 폴리 위에서 agglomeration, 누설을 만드는 파이핑, 미반응 금속 브리지.
습식 스트립(SPM 등)으로 미반응 금속을 걷어 내는 순간, 칩은 비로소 저저항 단자를 갖는다.
6) MOL — 콘택, 텅스텐 플러그
CESL: 질화막 스트레스 라이너. NMOS에는 인장, PMOS에는 압축을 줘 이동도를 억지로 끌어올린 세대(65/45 nm 스트레스 엔지니어링).
ILD0: BPSG 리플로우(구세대) 또는 HDP + CMP.
콘택 홀: 고종횡비 식각, 스토퍼 SiN.
배리어 Ti/TiN + W CVD (WF6 + SiH4/H2).
W CMP로 플러그만 남김.
콘택 하나가 안 열리면 그 트랜지스터는 세상에서 사라진다. 수천억 개 콘택의 오픈/브리지가 수율 파레토 1위인 팹이 많다. 보우(bow) 프로파일, 배리어 미커버리지, W 심(seam)이 단골 범인이다.
7) BEOL — 구리 도시의 반복 공사
알루미늄 배선(0.18 µm 이전 주류)은 식각으로 선을 깎았다. 구리는 식각이 거의 안 된다. 그래서 다마신: 절연막을 먼저 파고, 구리를 채워, CMP로 닦는다.
싱글 다마신: 비아와 메탈을 따로.
듀얼 다마신: 비아+메탈을 한 번에 채워 원가와 계면을 줄인다. 비아 퍼스트 / 트렌치 퍼스트 / 셀프얼라인 비아 등 변종이 파운드리마다 비밀 레시피.
스택:
Etch stop (SiCN 등)
Low-k (SiOCH, k~2.5–3.0) 또는 ULK + pore sealer
TaN/Ta 배리어 + Cu 시드 스퍼터
전기도금으로 트렌치를 채움 (첨가제: 가속제/억제제/평탄제)
어닐로 그레인 성장 → 일렉트로마이그레이션 수명↑
Cu CMP, 그 다음 캡 SiCN
M1은 가장 촘촘하고 얇다(속도). 위층으로 갈수록 두껍고 넓다(전력·클록). 평면 28 nm 로직이면 금속 8~10층이 흔하다. 임베디드는 5~6층으로 원가를 깎는다.
Low-k의 비극: 구리를 가까이 붙이면 용량이 커져 RC 지연이 폭발한다. 구멍을 낸 ULK는 약해서 CMP와 패키지 스트레스에 크랙이 난다. 그래서 k를 낮추는 전쟁과, 안 깨지게 하는 전쟁이 동시에 진행된다.
8) 패시베이션, 패드, 테스트
SiN / SiO2 적층으로 수분·나트륨 차단 (모바일 이온은 Vt를 평생 밀어 버린다).
본딩 패드 오픈, Al 캡 또는 Cu 패드 + Ni/Pd/Au.
웨이퍼 프로브(CP), 리페어(메모리 퓨즈/안티퓨즈), 백그라인드, 다이싱, 패키지, FT.
여기까지가 표준 평면 CMOS 플로우의 끝이다. 이후는 어셈블리 세상.
단위 스텝을 “왜 이 온도인가”로 다시 읽기
| 구간 | 대표 온도 | 왜 그 온도인가 | 넘으면 생기는 일 |
|---|---|---|---|
| 게이트 산화 | 800~950 °C | 계면 Dit↓, 막질 | 웰 도펀트 재확산 |
| Spike 활성화 | ~1050 °C, <1 s | 활성화 vs 확산 타협 | 정션 깊어져 SCE |
| NiSi 형성 | 300~450 °C | NiSi 상, agglomeration 회피 | NiSi2, 누설 |
| Cu 어닐 | 150~300 °C | 그레인, 스트레스 | Low-k 손상, 힐록 |
| PI 큐어 | ~300 °C | 이미드화 | Cu 산화, 워페이지 |
열 예산은 위에서 아래로 합산한다. BEOL을 열 때마다 FEOL 정션이 미세하게 움직인다. 그래서 후반 공정은 집요하게 저온이다.
⚠️ 나노 한계 결함 및 현장 해결책
평면 CMOS가 28 nm 근처에서 “표준의 왕좌”를 내준 이유와, 그 이전부터 팹이 싸워 온 불량을 묶어서 본다.
1. 단채널 효과 (SCE)와 누설
게이트가 짧아지면 드레인 전계가 채널을 뚫고 문턱을 끌어내린다(DIBL). 끄면 꺼지지 않는 트랜지스터가 된다.
해결 역사: Halo, 초얕은 정션, 채널 도핑↑ — 그러나 도핑을 올리면 쿨롱 산란으로 이동도가 죽는다. 고유전율로 전기적 두께만 줄이고 물리 두께는 유지. 그래도 부족해 FinFET이 채널을 세웠다.
2. 게이트 누설과 소프트 브레이크다운
SiO2 1.2 nm는 터널링 창살이다. 칩 전체가 꺼져 있어도 와트가 샌다.
SiON 질화 → HKMG.
트랩 생성은 PBTI/NBTI로 수명 사양(10년, 125 °C)을 위협. 일함수 금속과 IL 최적화가 신뢰성 팀의 밥.
3. 랜덤 도펀트 요동 (RDF)
채널에 붕소 원자가 몇십 개. 같은 레이아웃인데 Vt가 제각각. SRAM 6T는 이 때문에 셀 면적과 Vmin이 결정된다. 해결은 도핑을 줄이는 방향 — 결국 완전공핍 FinFET/FDSOI로 이어진다.
4. 래치업
기생 NPN+PNP가 사이리스터를 이룬다. I/O 핀에 ESD 한 방이 들어가면 칩이 켜진 채로 녹는다.
에피 기판, 가드링, 트리플 웰, STI 깊이, 웰 도즈. 설계 룰의 “이 간격 이하 금지”가 곧 공정 능력이다.
5. 핫캐리어 (HCI)
짧은 채널의 고전계가 전자를 가속해 산화막에 처박는다. 수명 동안 Id sat이 mar는다. 드레인 엔지니어링, 전압 스펙 다운, 스페이서 최적화가 약.
6. 실리사이드·콘택
좁은 라인 NiSi 뭉침, 콘택 오픈, 배리어 미커버. 인라인 CD-SEM, e-beam 검사, voltage contrast가 수율 탐정이다.
7. Cu 일렉트로마이그레이션 / TDDB
전자바람이 Cu 원자를 쓸어 via를 비운다. Low-k는 전계에 약해 TDDB. 캡층, via 필릿, 전류 밀도 룰, 수분 봉지가 해법. 패키지 리플로 260 °C가 ULK 크랙을 내는 칩-패키지 상호작용(CPI) 도 평면 후반 세대의 단골 사고다.
8. 파티클과 스크래치
CMP 스크래치 한 줄이 메탈 브리지. 세정 후 워터마크가 게이트 위에 앉으면 그 다이는 사망. 팹의 진짜 전쟁은 사진보다 청소에 가깝다.
📊 세대별·방식별 스펙 비교
| 항목 | 0.35~0.18 µm | 130~90 nm | 65~45 nm | 32~28 nm 평면 | (참고) 16/14 FinFET |
|---|---|---|---|---|---|
| 게이트 | Poly / SiO2 | Poly / SiON | Poly/SiON + 스트레스 | HKMG RMG | HKMG + Fin |
| 배선 | Al, W 비아 | Cu 도입 | Cu + low-k | Cu + ULK | Cu + ULK, Co/Ru 캡 |
| 실리사이드 | TiSi2 | CoSi2 | NiSi | NiPtSi | Ni/Ti silicide 변형 |
| 리소 | KrF 248 | ArF 193 | 193 이머전 | 이머전 + DPT 직전 | EUV 진입 |
| 금속층 | 4~6 | 6~8 | 8~10 | 8~11 | 10~15+ |
| 강점 | 원가, HV 쉬움 | 밀도 | 속도 | 평면 마지막 밀도 | 누설·SCE |
| 약점 | 면적 | 게이트 누설 | RDF, NBTI | SCE로 벽 | 원가, 기생 |
| 주력 응용 | MCU, PMIC | 초기 모바일 | 스마트폰 AP | 28 nm 장기 노드 | 고성능 로직 |
같은 28 nm라도 HPC 고성능 버전, LP 저누설, HPC+ 중간이 나뉜다. Vt를 3~4종(SVT/LVT/ULVT/HVT) 심는 멀티 Vt가 표준이다. 마스크가 늘고 주입 스텝이 늘지만, 라이브러리가 전력을 고른다.
DRAM 주변 회로는 이 플로우를 커패시터 고온(셀 산화, 스택 식각 후 어닐) 과 싸워 가며 끼워 넣는다. 로직 순수 플로우보다 열 예산이 가혹해 실리사이드와 정션이 항상 타협 대상이다.
🏢 글로벌 파운드리·메모리·장비 생태계 및 업계 실측
TSMC: 28 nm HKMG를 “오래 파는 노드”로 만든 장본인. 28HPC/HPC+/HPC+ 후속, 22 nm 울트라 저누설까지 평면 계보를 연장. 성숙 노드 가동률이 회사 현금창이다.
삼성 파운드리: 28 nm 게이트 퍼스트 HKMG로 한때 속도전. 이후 FinFET으로 무게 이동. 레거시 8인치(130~180 nm)는 별도 라인에서 자동차·PMIC.
인텔: 45/32 nm에서 HKMG+스트레인 실리콘을 양산으로 증명한 쪽. 평면의 마지막을 공격적으로 밀어 붙인 뒤 트라이게이트로 점프.
SMIC / UMC / GlobalFoundries: 40/28/22 nm 평면과 FD-SOI(GF 22FDX)로 “FinFET 가기 전 마지막 가성비” 시장을 먹는다. 자동차·IoT·RF 스위치가 고객.
SK하이닉스 / 삼성 메모리: 셀은 3D여도 페리 CMOS는 평면 로직 플로우의 사촌. 고온 모듈과 정합시키는 통합이 핵심 노하우.
ASML: 이 플로우의 게이트·M1을 찍는 193 nm 이머전. EUV는 평면 표준의 주인공이 아니다.
Lam Research / TEL / AMAT: 트렌치, 게이트 식각, W, Cu 배리어/시드, 에피.
ASMI / TEL ALD: HfO2 게이트.
KLA / AMAT 검사: 광학 + e-beam. 수율은 장비 스펙이 아니라 결함을 얼마나 빨리 분류하느냐로 갈린다.
Ebara / AMAT CMP: Cu/W/STI 평탄화가 수율의 침묵의 지배자.
현장 실측 감각 (공개 범위에서):
300 mm 로직 팹 한 장의 사이클 타임: 성숙 28 nm 약 2~3개월.
마스크 세트 가격: 28 nm 수억~십수억 원대. 그래서 MPW(멀티 프로젝트 웨이퍼)가 학계·스타트업의 숨구멍.
수율: 성숙 노드는 프로브 수율 80~95%대를 목표. 신규 노드는 수율 커브가 회사의 주가다.
28 nm는 원가/성능/IP 생태계(ARM, 인터페이스 PHY) 가 맞아 “영원히 안 죽는 노드”로 불린다.
공정 통합자가 매일 외우는 우선순위
1. 열 예산 역산: 마지막 어닐부터 적어 내려가며 정션 프로파일을 지킨다. 2. 계면 청정: 게이트 산화 직전 HF-last의 대기 시간(queue time)이 분 단위로 GOI를 가른다. 3. 스트레스 밸런스: STI, CESL, 실리사이드, 메탈 슬롯이 워페이지를 만들고 리소 오버레이를 망친다. 4. 디자인 룰과의 계약: 최소 게이트, 콘택 엔클로저, via 커버, 안테나 룰, 래치업 간격 — 공정이 못 지키면 룰을 늘리고, 룰을 늘리면 칩이 비대해진다. 5. 모듈 독립성 환상 버리기: 콘택 식각이 게이트 스페이서를 깎으면 실리사이드가 죽는다. 한 모듈의 “개선”이 세 모듈의 불량이다.
실무자가 그리는 “한 사이클”의 감정선
아침 미팅의 파레토는 늘 비슷하다. 파티클, 스크래치, CD, 오버레이, 막두께. 극적인 불량은 오히려 드물다. 평면 CMOS 표준 플로우가 강력한 이유는 천 번을 반복해도 같은 트랜지스터가 나오게 만든 레시피의 보수성 이다. 혁신이 필요할 때는 모듈 하나만 갈아 끼운다. SiO2를 HfO2로, Al을 Cu로, TiSi2를 NiSi로. 뼈대(격리-게이트-정션-콘택-배선-보호)는 60년 가까이 같다.
그 뼈대를 이해하면 FinFET도 GAA도 같은 문장의 수식어로 읽힌다. 채널 모양만 바뀌었을 뿐, 웨이퍼는 여전히 같은 순서로 집을 짓는다.
🔗 관련 링크
핸드북 내부 연계 학습:
필수 전공정 단위기술: 0.1 리소그래피 · 0.2 식각 · 0.4 이온 주입
MOSFET 소자 물성 및 차세대 진화: 2.1 GCA 모델링 · 2.2 문턱전압 엔지니어링 · 3.1 3D FinFET 혁명
관련 챕터: 2.1 웨이퍼와 결정 · 2.2 산화/확산/이온주입 · 2.3 리소그래피 · 2.4 식각과 CMP · 2.6 salicide와 MOL · 2.7 Cu/low-k BEOL · 3.x 단채널과 HKMG · 4.x FinFET으로의 전환.
연계 실시간 산업 동향
※ 해당 개념의 24시간 내 직접 속보가 없어 반도체 공학 편 대표 실시간 공급망 뉴스를 연동합니다.
SK하이닉스, 세계 최초 16단 HBM4 양산 출하 개시… TSMC CoWoS-L 공정 직결
SK하이닉스가 6세대 HBM4 16단 48GB 모듈 양산에 돌입했다. 베이스 다이에 TSMC 3나노 파운드리 공정을 적용하고 Cu-Cu 하이브리드 본딩을 결합하여 대역폭 2.2TB/s를 달성했다.
ASML, 차세대 0.55 High-NA EUV 노광기 'EXE:5200' 2026 출하 가속… 인텔·TSMC 14A 도입 경쟁
ASML이 시간당 웨이퍼 220매를 처리하는 0.55 NA High-NA EUV 상용 모델 EXE:5200 양산 라인 가동을 알렸다. 인텔 14A와 TSMC A14 공정의 2026-2027 도입 선점이 가시화된다.
TSMC, 2나노(N2) GAA 공정 양산 수율 70% 돌파… 애플 A19 Pro 전량 단독 생산 확정
TSMC 신주 바오산 20팹의 2nm 나노시트(GAA) 공정 수율이 70%대에 안착하며 애플 차세대 AP A19 Pro 양산에 들어갔다. 고성능 HPC 고객사를 겨냥한 N2P 및 후면전력 A16 준비도 순항 중이다.
석 달 만에 '사상 최대'…'60조' 마이크론, 다음은 '190조' 삼전닉스
미국 메모리 반도체 기업 마이크론테크놀로지가 사상 최대 분기 실적을 기록했다. 인공지능(AI) 데이터센터 투자 확대가 메모리 수요를 끌어올린 결과다. 다음 분기 실적 전망도 시장 기대를 웃돌았다. 메모리 슈퍼사이클에 대한 기대감이 커지는 가운데 시장의 시선은 삼성...
TSMC, AI 가속기 수요 폭증에 CoWoS 인터포저 생산능력 월 6.5만 장으로 긴급 증설
엔비디아 블랙웰 및 커스텀 ASIC 수요 확대에 따라 TSMC 타이난 첨단 패키징 6공장의 CoWoS-L/S 라인을 풀가동하고, 2026년 말까지 월 생산능력을 기존 목표치 대비 25% 상향했다.
삼성전기·SKC, 2026 차세대 글라스 기판 파일럿 라인 가동… 대면적 칩렛 패키징 패러다임 전환
유기 기판(FC-BGA)의 휨 현상과 미세 피치 한계를 극복하는 글라스 기판이 양산 검증에 들어갔다. TGV(Through Glass Via) 가공 수율 개선으로 AI 가속기용 기판 공급망 진입이 임박했다.
Deep Dive 연계 학술 논문
300mm 웨이퍼 공정 기반 99.9% 초고충실도 실리콘 스핀 큐비트 코히런트 제어 기술
A. Morello, A. S. Dzurak, M. Veldhorst et al.
동위원소 정제 28Si MOS 양자점 소자를 300mm 상용 팹 라인에서 제작하여 99.94% 단일 큐비트 게이트 충실도와 99.82% 2-큐비트 교환 게이트 충실도를 달성함으로써 양자 표면 부호 오류 수정 임계값을 돌파했다.
에지 생성형 AI를 위한 16단 3D 적층 28Gbps/pin 64GB 초저전력 LPDDR6 D램
H. C. Shin, K. W. Park, D. H. Kim et al.
0.55V 코어 전압에서 핀당 28 Gbps 대역폭을 내는 16단 적층 모바일 D램으로, 분할 뱅크 파워 게이팅과 적응형 셀프 리프레시를 통해 대기 전력을 5mW 미만으로 억제했다.
64개 아날로그 전도도 상태를 지원하는 저편차 1.8nm HfZrOx 강유전체 터널 접합(FTJ) 시냅스
A. Chouprik, M. Spiridonov, A. Chernikova et al.
원자층 증착(ALD)으로 형성된 1.8nm 초박막 Hf0.5Zr0.5O2 터널 장벽을 적용하여 사이클 간 편차 2.8% 미만으로 64개 아날로그 전도도를 제어하는 고정밀 인메모리 컴퓨팅 소자를 구현했다.
Programmable nonlinearity within nanophotonic waveguides
Benjamin A. Ash, Ryotatsu Yanagimoto, Mandar M. Sohoni et al.
Nonlinear nanophotonics enables the engineering of optical functions using light-matter interactions in nanoscale structures with carefully designed geometries. Phase matching in nonlinear optics is typically essential for realizing high efficiency for desired processes and engineering of sophisticated functions, but it can be challenging to reliably achieve in nanophotonic waveguides. Conventionally, phase matching in nanophotonics is achieved through nanofabrication, e.g., by poling a device's nonlinear material using electrodes with fixed geometry. This approach has two drawbacks: the optical functions a device can perform are fixed at the time of fabrication, and the device's performance can be degraded by fabrication imperfections. Here, we circumvent these limitations by engineering programmable $χ^{(2)}$ holograms inside nanophotonic waveguides, enabling reconfigurable quasi-phase matching that can be updated after device fabrication in approximately one second. By projecting structured optical illumination onto photoconductive electrodes, we generated spatial patterns of electric-field-induced $χ^{(2)}$ to exert spectral, modal, and polarization control over three-wave mixing processes. This programmability also allowed us to employ closed-loop in situ optimization to compensate for phase mismatch in complex waveguide structures, such as width-modulated waveguides and spiral waveguides exceeding 10 cm in length. Furthermore, we show that programmable nonlinearity enables powerful in situ diagnostics, including direct dispersion measurements of various transverse modes and on-chip wavefront phase tomography. Our work opens up the possibility of building cascaded nonlinear nanophotonic systems where yield issues due to fabrication variations can be sidestepped while retaining the benefits of etched waveguides such as confinement and dispersion engineering.
Single-Pulse Optical Switching combined with Current-Induced Motion of Skyrmionic Spin Textures
Edoardo Mangini, Duc Minh Tran, Boonthum Kunyangyuen et al.
Magnetic skyrmions are promising nanoscale information carriers because their position can be manipulated by electrical currents. The additional ability of deterministic control of the spin structure would allow the use of magnetic skyrmions as multi-state bits, expanding the capabilities of skyrmion devices further. Such control could be realized by coupling all-optical helicity independent switching of magnetization (AO-HIS) to magnetic skyrmions. This is realized in a Pt/Ir/CoB/Gd/Pt multilayer that is engineered to stabilize magnetic skyrmions and, at the same time, enable AO-HIS by single ultrafast laser pulse. Laser excitation is used to write skyrmionic textures, whose polarity is selected by a small applied out-of-plane field. A single 30 fs laser pulse is then used to toggle the magnetization of an illuminated region containing skyrmionic textures, reversing their polarities without requiring any magnetic field or current pulses. This establishes deterministic optical switching of the skyrmion spin structure as a new manipulation channel, distinct from previously reported optical nucleation and annihilation. The material is then patterned into a wire, to combine the optical manipulation with current-induced skyrmion motion. These results establish a route toward opto-spintronic skyrmion devices in which light programs the internal state of a skyrmion and electrical currents control its position.