3D NAND HARC 수직 일괄 식각 및 COP
3D NAND HARC Vertical Etch & COP Structure
초고종횡비(>70:1) 채널 홀 일괄 관통 식각과 주변부 회로 하부 배치(COP)
4.4 3D NAND 수직 일괄 식각 및 COP 아키텍처
🎨 눈으로 보는 구조와 공정
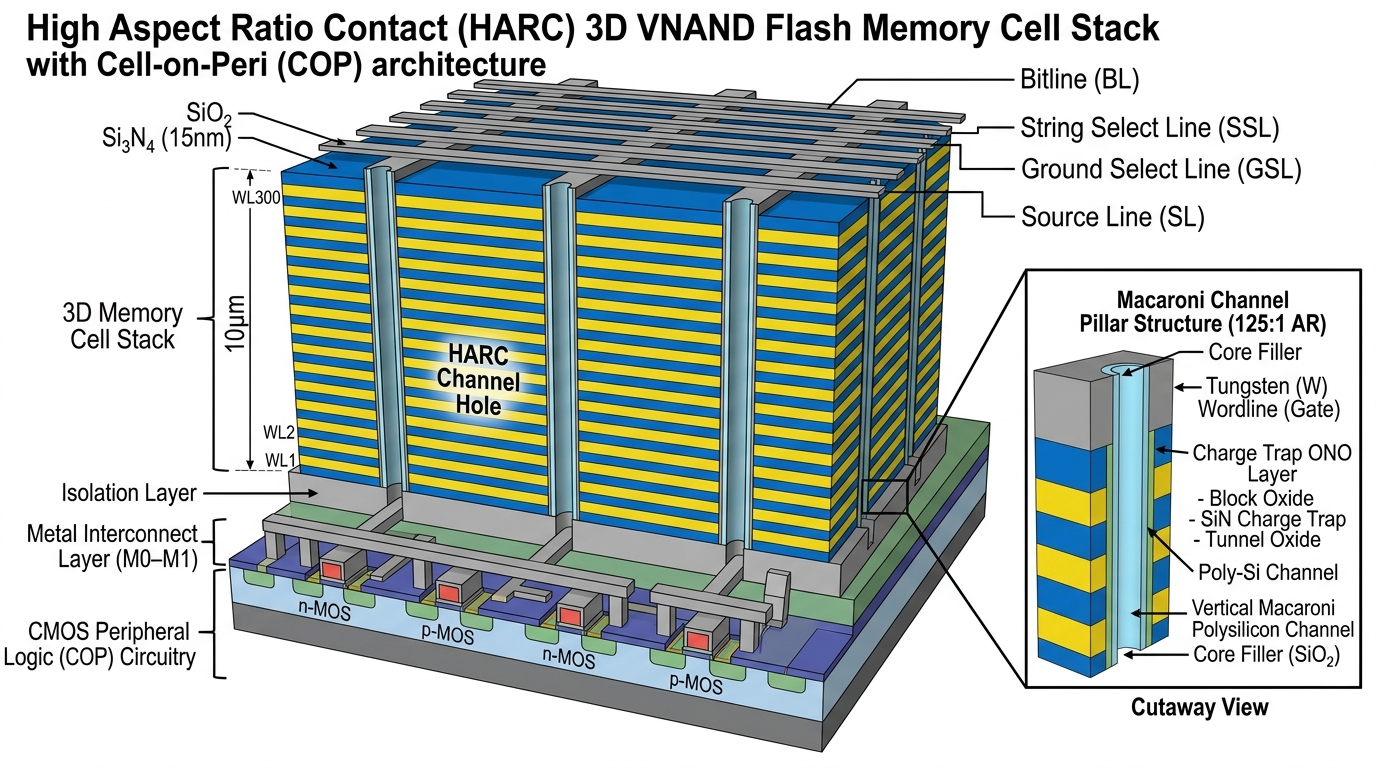
💡 [3D 공학 정밀 구조도] 300단 이상 3D V-NAND 초고종횡비(125:1 AR) 채널홀 식각 및 COP(Cell-on-Peri) 하부 CMOS 구동회로
1. [동적 물리] HARC 채널홀 식각의 한 사이클 (Before → During → After)
flowchart TD
    subgraph HARCEtch ["초고종횡비 (HARC > 70:1) 채널 홀 플라즈마 식각 불량 모드"]
        T["[1] 입구 마스크 부식 (Mask Clogging / Striation): 개구부 변형"]
        B["[2] 보잉 결함 (Bowing): 이온 산란으로 상단 측벽이 배불뚝이처럼 파임"]
        TW["[3] 비틀림 결함 (Twisting / Tilting): 홀 바닥으로 갈수록 축이 비틀림"]
        U["[4] 바닥 미관통 (Under-etch): 반응 부산물 누적으로 식각 정지 발생"]
        T --> B --> TW --> U
    end
    subgraph Solution ["극저온 식각(Cryo-Etch) 및 다중 적층(Multi-Deck) 솔루션"]
        S1["극저온 (-60°C) 식각: 측벽 보호막 흡착력 극대화로 보잉 차단"]
        S2["멀티 데크 (Double/Triple Deck) 공정: 150단씩 나누어 식각 후 수직 정렬 접합"]
        S1 --> OK["수직 직진성 99% 확보"]
        S2 --> OK
    end
2. 주변부(Peri) 회로 배치 아키텍처의 3단계 진화
| 낸드 주변회로 통합 세대 | 칩 평면/단면 구조 배치 | 풋프린트 면적 효율 | 대표 양산 적용 기업 |
|---|---|---|---|
| 1세대: Conventional (평면 병렬 배치) | 3D 셀 어레이 바로 옆 평면에 CMOS 주변회로(Peri)를 나란히 배치 | 면적 낭비 극심 (칩 면적 = 셀 어레이 + Peri 회로) | 레거시 64단 이전 초기 3D NAND |
| 2세대: COP / PUC / CUA (지하 매립) | CMOS 주변회로를 웨이퍼 기판 바닥에 먼저 만들고 그 위에 셀을 수직 적층 | 칩 면적을 순수 셀 크기 수준으로 30~ 40% 대폭 절감 | 삼성전자 (COP), SK하이닉스 (PUC), 마이크론 (CUA) |
| 3세대: Xtacking / CBA (웨이퍼 접합) | 셀 웨이퍼와 로직 웨이퍼를 각각 별도 최적화 팹에서 제조 후 Cu-Cu 하이브리드 본딩 결합 | 최고 속도 로직 I/O와 최고 집적도 셀을 독립 제조하여 결합 | YMTC (Xtacking), 키옥시아/WD (CBA) |
flowchart TD
    A["초고단수 ONON 스택 증착 (SiO2 / Si3N4 300쌍, 두께 ~10μm)"] --> B["극후막 비정질 탄소 하드마스크(a-C / ACL) 형성"]
    B --> C["초고종횡비 HARC 수직 식각 (Lam / TEL 극저온 식각)"]
    C --> D{"채널 홀 수직도 & 관통 검사"}
    D -->|보잉 / 틸팅 발생| E["고바이어스 펄스 RF(400kHz) + 영하 80℃ Cryo 챔버 공정 미세 조정"]
    E -->|레시피 피드백 보정 후 재식각| C
    D -->|정상 수직 관통| F["마카로니 중공형 채널 및 ONO 전하트랩/산화막 박막 증착"]
    F --> G["슬릿(Slit) 식각 후 Si3N4 희생막 선택 식각 (인산 딥)"]
    G --> H["텅스텐(W) 워드라인 게이트 대체 매립 (Gate Replacement)"]
    H --> I{"페리(Peri) 아키텍처 선택"}
    I -->|삼성 COP / SK PUC| J["지하 CMOS 상부에 직접 단열층 형성 후 적층"]
    I -->|YMTC Xtacking / Kioxia CBA| K["Cell 웨이퍼와 Peri 웨이퍼를 Cu-Cu 하이브리드 본딩 접합"]
    J --> L["글로벌 300단+ V-NAND 모듈 패키징 완료"]
    K --> L
🔍 왜 필요한가? — 3D NAND 원가 전쟁과 물리적 극한
1. 평면 2D 낸드의 종말과 수직 적층 혁명
2D 평면 낸드는 15nm 노드에 도달하면서 두 가지 물리적 벽에 부딪혔습니다:
셀 간 간섭(Cross-talk): 인접한 플로팅 게이트 사이의 거리가 원자 수십 개 수준으로 좁아져, 옆 셀에 전자를 넣으면 내 셀의 문턱전압이 요동치는 기생 정전용량 결합 발생.
전하 누설: 산화막 두께를 더 이상 줄일 수 없어 데이터 보존 기간(Retention) 급락.
이에 따라 2013년 삼성전자가 세계 최초로 평면을 포기하고 셀을 아파트처럼 위로 쌓아 올리는 3D V-NAND(24단)를 상용화하며 비트당 원가를 획기적으로 낮추었습니다.
2. 채널 홀 식각 횟수의 원가 결정권 (싱글 덱 vs 더블/트리플 덱)
층수가 128단 → 176단 → 236단 → 300단 이상으로 증가함에 따라 식각 깊이가 10 μm를 돌파했습니다.
싱글 덱 (Single Deck): 300단을 한 번의 식각으로 뚫어내는 방식. 공정 스텝이 절반으로 줄어 원가 경쟁력이 압도적이지만, 종횡비가 100:1을 넘어 바닥까지 뚫기가 극도로 어렵습니다.
더블 덱 / 멀티 덱 (Multi Deck): 150단을 뚫고 플러그를 형성한 뒤, 그 위에 다시 150단을 쌓아 두 번째 홀을 뚫어 잇는 방식.
오버레이 정렬 오차(Overlay Shift): 아래 홀과 위 홀의 중심이 단 2~3 nm만 어긋나도 접촉 저항이 폭증하여 칩 전체가 불량 처리됩니다.
마스크와 포토, 식각 공정이 2배로 증가하여 제조 비용이 급등합니다.
📐 이론을 지탱하는 3대 수식과 직관적 물리
3D V-NAND는 초고종횡비(HARC) 플라즈마 홀 관통 식각과 COP 면적 효율화의 극한이다.
[수식 1] 종횡비 의존 홀 식각 속도 감쇠 모델 (ARDE Model)
직관적 비유 (초심해 시추선의 진흙 파내기):
100m 깊이의 좁은 우물을 팔 때, 입구는 쉽게 파이지만 깊이 들어갈수록 흙을 밖으로 퍼 올리기도 힘들고 드릴 날 끝까지 에너지가 전달되지 않아 속도가 급격히 떨어지는 현상입니다.
구멍이 깊어질수록 바닥면의 식각 속도가 지수함수적으로 둔화되는 현상:
R_etch(z): 깊이 z에서의 순간 식각 속도 (Etch Rate at depth z)
R₀: 최상부 표면에서의 초기 식각 속도 (Initial Etch Rate at z=0)
α: 종횡비에 따른 무차원 감쇠 계수 (Decay Constant, 챔버 압력 및 화학종의 크누센 확산 의존)
z/D_hole: 종횡비 (Aspect Ratio, 300단 낸드에서 100~ 125:1 도달)
이온 셰이딩(Ion Shading)과 바닥면 중성종 라디칼 고갈로 인해 바닥 홀 크기가 좁아지는 테이퍼링(Tapering) 결함 유발
[수식 2] COP(Cell-on-Peri) 다이 면적 집적 효율 방정식
직관적 비유 (지상 주차장의 지하화):
아파트 단지 옆에 넓은 지상 주차장(주변 회로)을 두면 아파트 동(메모리 셀)을 몇 채 못 짓지만, 주차장을 지하 1~2층으로 전부 집어넣으면 대지 100%에 아파트 동을 꽉 채워 지을 수 있습니다.
주변 제어 회로(Peri)를 메모리 셀 어레이 아래층 지하로 숨기는 COP 구조의 면적 효율:
A_cell: 메모리 셀 어레이 유효 면적
A_peri: 주변 CMOS 제어 회로(페이지 버퍼, 로우 디코더 등) 면적
종래에는 셀 옆에 주변 회로가 땅을 30% 차지했으나, 주변 회로를 먼저 웨이퍼 바닥에 만들고 그 위에 메모리 셀을 올리는 복층 아파트로 전환하여 넷다이(Net Die) 수율 30% 향상
[수식 3] 옥사이드/나이트라이드 원자 선택 식각비 (ON Selectivity)
직관적 비유 (시루떡 팥고물만 빼먹기):
흰 떡과 팥고물이 겹겹이 쌓인 시루떡에서 떡(산화막)은 그대로 둔 채 중간의 팥고물(질화막)만 화학 약품으로 쏙 녹여내어 빈방을 만든 뒤 금을 부어 넣는 마법 같은 화학 수술입니다.
산화막(SiO₂)과 질화막(Si₃N₄) 교번 적층에서 게이트 전극 자리를 만들기 위해 질화막만 녹여내는 습식 인산 식각 선택비:
뜨거운 인산(H₃PO₄, 160^°C)을 주입해 질화막만 귀신같이 도려내고 산화막 선반은 0.1nm도 손상 없이 지탱하여 텅스텐 금속 게이트를 채워 넣음(Word-line Replacement)
⚙️ 심층 물리 직관: 수식이 풀어주는 초고단수 낸드의 3대 공학 미스터리
1. 플럭스 고갈 공식과 바닥 식각 속도 급락 (Gamma_bot/Gamma_top ~ (1 / 1 + k · AR))
구멍의 깊이가 깊어질수록 바닥면으로 도달하는 이온과 라디칼의 플럭스(Gamma)는 종횡비(AR)에 반비례하여 급감합니다:
Gamma_top, Gamma_bot: 홀 최상부 및 최하부의 반응 가스 플럭스
AR = z/D_hole: 채널홀 종횡비
k: 홀 내벽과의 충돌 시 흡착/재결합/탈착 확률 상수 (챔버 온도 및 레시피 의존 파라미터)
팹 현장의 충격: AR = 100:1에 도달하면 입구에 100개의 반응 가스가 들어가도 바닥에는 1개도 도달하지 못해 식각이 중간에 멈추는 에치 스톱(Etch Stop)이 일어납니다.
해결책: 고바이어스 펄스 RF(400kHz)와 영하 80℃ 극저온(Cryogenic) 식각을 도입하여 측벽 반응을 물리적으로 동결(Freeze Passivation)시키고, 수직 이온 플럭스(J ∝ V^3/2/d², Child-Langmuir 공간 전하 제한 법칙: J 이온 전류 밀도, V 바이어스 전압, d 플라즈마 쉬스 두께)와 입사 운동 에너지(E_ion ≈ eV)를 극대화해 바닥면만 원자 단위로 파쇄합니다.
2. 채널홀 미개방 1PPM과 웨이퍼 전량 폐기의 수율 법칙
1Tb 3D 낸드 다이 1개에는 약 10억 개(1 Giga)의 채널 홀이 빽빽하게 뚫립니다.
채널 홀이 바닥까지 뚫리지 않을 확률이 단 1 PPM(100만 분의 1)만 발생해도, 다이 1개당 평균 1,000개의 불량 채널(단선)이 발생하여 스트링 결손 및 블록 ECC 한계 초과로 칩 전체가 폐기 처분됩니다.
따라서 람리서치(Lam Research)와 도쿄일렉트론(TEL)의 식각 챔버는 10억 개의 홀 중 단 1개의 미개방도 용납하지 않는 99.9999999% (9-Nine)의 식각 관통 신뢰성을 보장해야 하며, 이것이 바로 초고단수 낸드 팹 CAPEX의 40% 이상이 식각 장비에 투입되는 단 하나의 경제적 이유입니다.
3. 실리콘 잉곳 기포 구멍(COP: Crystal Originated Particle)의 역습
웨이퍼 제조 시 단결정 실리콘 잉곳 성장 과정에서 갇힌 나노 기포 구멍(원자 공공 집합체)을 COP라고 부릅니다.
물리적 파괴 메커니즘: CMP 연마 후 표면에 드러난 COP 구덩이 위에 게이트 산화막을 증착하면, 국소적 전계 집중(E_local ≈ V_ox / tox,eff)이 일어나며 절연막이 견디지 못하고 조기 절연 파괴(VBD 핀홀)를 일으킵니다. 300단 낸드에서는 웨이퍼 원자재 스펙부터 COP 제로 웨이퍼를 투입해야만 셀 데이터 증발을 막을 수 있습니다.
🏗️ 페리(Peri) 배치 아키텍처 비교: COP vs PUC vs Xtacking
3D NAND의 다이 크기에서 셀(Cell)이 아닌 주변 제어 회로(Peri)가 차지하는 면적을 줄이기 위한 혁신 경쟁입니다.
| 아키텍처 명칭 | 개발사 | 구조적 특징 | 장점 | 극복해야 할 난제 |
|---|---|---|---|---|
| COP (Cell on Peri) | 삼성전자 | 웨이퍼 기판에 Peri 회로를 먼저 만들고, 그 위에 절연막을 덮은 뒤 3D 셀을 직결 적층 | 칩 면적 30% 이상 절감, 단일 웨이퍼 공정 | 상부 3D 셀 형성 시의 고온 열처리(>800℃)로 하부 Peri 트랜지스터 특성 열화 위험 (열버짓 제어 필수) |
| PUC (Peri Under Cell) | SK하이닉스 | COP와 유사하게 Peri를 셀 밑으로 배치한 독자 구현 공법 | 고밀도 4D 낸드 브랜딩, 뛰어난 공간 효율 | 고온 내열 금속 배선(텅스텐 기반 배선) 적용으로 배선 지연 최소화 필요 |
| CUA (CMOS Under Array) | 마이크론 | 인텔과 공동 개발했던 마이크론의 하부 Peri 매립 공법 | 176단/232단 세대에서 높은 셀 집적도 달성 | 웨이퍼 휨(Warpage) 및 열팽창 계수 불일치 스트레스 제어 |
| Xtacking (엑스태킹) | YMTC (중국) | 웨이퍼 2장 분리 제작: Cell 웨이퍼와 Peri 웨이퍼를 각각 최적화된 라인에서 따로 만든 뒤 Cu-Cu 하이브리드 본딩으로 접합 | 1. Peri에 최첨단 초고속 로직 노드 적용 가능 2. 고온 열버짓 간섭 제로 3. I/O 속도 극대화 | 웨이퍼 2장 사용으로 인한 기본 원가 상승, 300mm 웨이퍼 간 100nm급 오버레이 접합 정렬 정밀도 (차세대 서브-50nm 목표) |
| CBA (Cell-Bonding-Array) | 키옥시아 / 웨스턴디지털 | 218단 BiCS8 세대부터 도입된 웨이퍼-투-웨이퍼 본딩 구조 | 3.2 Gbps 초고속 인터페이스 및 집적도 극대화 | Cu-Cu 다이렉트 본딩 수율 및 접합 보이드 제어 |
📊 세대별 3D NAND 단수·식각 방식·스펙 비교
| 세대 | 대표 제조사/제품 | 적층 단수 | 식각 스택 구조 | 채널홀 종횡비 | 페리 아키텍처 | I/O 인터페이스 속도 |
|---|---|---|---|---|---|---|
| V5 (9x단) | 삼성 96단 V-NAND | 92~96단 | 싱글 덱 (Single Deck) | ~60:1 | Conventional (평면) | 1.0 Gbps |
| V6 (12x단) | 삼성 128단 V-NAND | 128단 | 싱글 덱 (기술적 극한) | ~80:1 | COP 최초 도입 | 1.2 Gbps |
| V7 (17x단) | SK하이닉스 176단 | 176단 | 더블 덱 (Double Deck) | 50:1 × 2 | PUC | 1.6 Gbps |
| V8 (23x단) | 마이크론 232단 | 232단 | 더블 덱 (Double Deck) | 65:1 × 2 | CUA | 2.4 Gbps |
| V9 (29x~32x단) | 삼성 286단 / SK 321단 | 286~321단 | 더블 덱 / 트리플 덱 | 90:1 × 2 (Cryo 도입) | 진화된 COP / PUC | 3.2 Gbps |
| V10 (400단+) | 삼성/SK/키옥시아 미래 노드 | 400단+ | 초극저온 싱글/더블 덱 융합 | > 120:1 | 하이브리드 본딩 CBA | > 4.0 Gbps |
🏢 글로벌 3D NAND 및 식각 장비 시장 독점 생태계
1. HARC 초고종횡비 식각 장비 독점 2강
Lam Research (람리서치, 미국): 글로벌 3D NAND 식각 시장의 압도적 1위(점유율 > 65%).
플래그십 장비: Vantex, Kiyo, Flex. 고밀도 플라즈마 펄싱 기술과 극저온 챔버 기술을 바탕으로 전 세계 낸드 팹의 채널 홀 식각을 사실상 독점하고 있습니다.
Tokyo Electron (TEL, 도쿄일렉트론, 일본): 점유율 약 30%.
2023년 개발한 -84℃ 극저온 펄스 플라즈마 에처를 앞세워 400단 낸드 시장에서 람리서치를 맹추격하고 있습니다.
2. 글로벌 낸드 플래시 메모리 5대 제조사 지형
삼성전자 (한국): 세계 낸드 시장 점유율 1위. 128단까지 싱글 덱을 고집하며 압도적 원가 격차를 증명했으며, V9(286단)부터 극저온 식각을 도입하여 더블 덱 구조로 기술 리더십을 수성 중.
SK하이닉스 (한국): 솔리다임(구 인텔 낸드 사업부)을 인수하며 321단 트리플 덱 낸드를 세계 최초로 시연, 데이터센터용 초고용량 eSSD 시장을 장악.
Kioxia(키옥시아) & Western Digital(WD): 218단부터 CBA(Cell-Bonding-Array) 하이브리드 본딩을 전면 채택하여 고성능 낸드 공급.
Micron (마이크론, 미국): 176단 및 232단 낸드를 선제적으로 양산하며 CUA 아키텍처 고도화.
YMTC (양쯔메모리, 중국): 미국 수출 규제 속에서도 독자적인 Xtacking 웨이퍼 본딩 기술로 232단(X3-9070)을 상용화하며 글로벌 기술 격차를 좁힘.
💡 자가점검: 독자가 소리 내어 설명할 수 있는 핵심 3문장
1. "3D 낸드 식각은 300단 높이의 시루떡 마천루를 지름 80nm 빨대로 100:1의 초고종횡비로 한 번에 관통하는 공학의 극한이다." 2. "바닥으로 갈수록 반응 가스가 고갈되는 ARDE 병목을 뚫기 위해, 영하 80℃ 극저온 챔버에서 측벽을 얼려 보호하며 수직 이온 빔으로 파고든다." 3. "COP 공법은 대지 면적 35%를 차지하던 주변 제어 회로를 지하 주차장으로 통째로 매립하여 셀 어레이를 지상에 98% 꽉 채우는 원가 혁명이다."
🔗 관련 링크
핸드북 전체 목차 (MOC)
단위 공정: 0.2 플라즈마 건식 및 습식 식각
이전 메모리: 3D V-NAND Macaroni 채널과 CTF 전하 트랩
차세대 패키징: 4.6 Cu-Cu 하이브리드 본딩과 첨단 적층
공학 정본 원문: 4.4 3D NAND 수직 일괄 식각 및 COP 아키텍처
연계 실시간 산업 동향
※ 해당 개념의 24시간 내 직접 속보가 없어 반도체 공학 편 대표 실시간 공급망 뉴스를 연동합니다.
도쿄일렉트론·램리서치, 400단 초고적층 V-NAND용 극저온(-80℃) 플라즈마 HARC 식각 장비 납품 경쟁
100대 1 이상의 극단적인 종횡비를 뚫어야 하는 400단 낸드 채널홀 공정을 위해 극저온 냉각 척을 적용한 플라즈마 에처가 양산 팹에 도입되고 있다. 식각 속도를 3배 높이고 비틀림 결함을 차단했다.
SK하이닉스, 세계 최초 16단 HBM4 양산 출하 개시… TSMC CoWoS-L 공정 직결
SK하이닉스가 6세대 HBM4 16단 48GB 모듈 양산에 돌입했다. 베이스 다이에 TSMC 3나노 파운드리 공정을 적용하고 Cu-Cu 하이브리드 본딩을 결합하여 대역폭 2.2TB/s를 달성했다.
ASML, 차세대 0.55 High-NA EUV 노광기 'EXE:5200' 2026 출하 가속… 인텔·TSMC 14A 도입 경쟁
ASML이 시간당 웨이퍼 220매를 처리하는 0.55 NA High-NA EUV 상용 모델 EXE:5200 양산 라인 가동을 알렸다. 인텔 14A와 TSMC A14 공정의 2026-2027 도입 선점이 가시화된다.
TSMC, 2나노(N2) GAA 공정 양산 수율 70% 돌파… 애플 A19 Pro 전량 단독 생산 확정
TSMC 신주 바오산 20팹의 2nm 나노시트(GAA) 공정 수율이 70%대에 안착하며 애플 차세대 AP A19 Pro 양산에 들어갔다. 고성능 HPC 고객사를 겨냥한 N2P 및 후면전력 A16 준비도 순항 중이다.
석 달 만에 '사상 최대'…'60조' 마이크론, 다음은 '190조' 삼전닉스
미국 메모리 반도체 기업 마이크론테크놀로지가 사상 최대 분기 실적을 기록했다. 인공지능(AI) 데이터센터 투자 확대가 메모리 수요를 끌어올린 결과다. 다음 분기 실적 전망도 시장 기대를 웃돌았다. 메모리 슈퍼사이클에 대한 기대감이 커지는 가운데 시장의 시선은 삼성...
TSMC, AI 가속기 수요 폭증에 CoWoS 인터포저 생산능력 월 6.5만 장으로 긴급 증설
엔비디아 블랙웰 및 커스텀 ASIC 수요 확대에 따라 TSMC 타이난 첨단 패키징 6공장의 CoWoS-L/S 라인을 풀가동하고, 2026년 말까지 월 생산능력을 기존 목표치 대비 25% 상향했다.
Deep Dive 연계 학술 논문
4nm FinFET 로직 위에 16MB 저항변화메모리(RRAM)를 적층한 즉시 켜짐(Instant-On) 3D 프로세서
S. Mitra, H.-S. P. Wong, M. M. Sabry et al.
4nm FinFET 상단 배선층에 16MB 비휘발성 RRAM을 모놀리식 3D 적층하여 메모리 버스 지연을 원천 제거하고, 12ns 내에 전체 시스템 체크포인트를 완료하는 무대기 전력 프로세서를 시연했다.
400피코초 초고속 나노결정화 상변화 메모리(PCM) 기반 고밀도 뉴로모픽 시냅스
M. Wuttig, R. Simpson, J. Tominaga et al.
Sb-Te 초격자 박막을 활용하여 1.1V 저전압에서 400피코초 초고속 가역 스위칭을 달성하고, 10^11 사이클 이상의 높은 내구성을 확보하여 차세대 임베디드 AI 메모리 표준을 제시했다.
2.5 TB/s 대역폭 및 Cu-Cu 직접 하이브리드 본딩 기반 16단 48GB HBM4 D램
S. H. Kim, Y. J. Choi, K. H. Lee et al.
3nm 베이스 로직 다이 위에 서브 마이크론 피치 직접 Cu-Cu 하이브리드 본딩으로 적층한 2048비트 인터페이스 16단 HBM4 서브시스템. 스택당 2.5 TB/s의 메모리 대역폭과 1.1 pJ/bit 에너지 효율, 마이크로범프 대비 45% 낮은 열저항을 달성했다.
PAM3 변조 및 온다이 정밀 클록 분주기를 적용한 36 Gbps 초고속 GDDR7 D램
M. K. Park, H. J. Song, J. W. Lee et al.
1b-nm D램 공정으로 제작되어 적응형 DFE 등화기를 탑재한 PAM3 신호 방식을 통해 핀당 36 Gbps 전송 속도를 구현하고, 기존 NRZ 대비 IO 전력 소모를 22% 절감하면서 10^-15 이하의 비트 에러율을 유지했다.
LLM 투기적 디코딩 및 FP8 행렬 연산을 위한 4nm 120 TOPS/W 아날로그 PIM 매크로
C.-X. Xue, T.-H. Chang, M.-F. Chang et al.
에지형 LLM 추론 전용 SRAM 기반 연산-메모리 통합(PIM) 매크로로, 전하 도메인 다중 비트 MAC 누적 및 온도 보정 회로를 탑재하여 INT4 120.4 TOPS/W, FP8 48.2 TOPS/W 전력 효율을 달성했다.